Arquitecturas en acción: integración, nube y automatización
1. Integración de datos en tiempo real
Los sistemas de bases de datos comunes utilizan normalmente la modalidad OLTP (On-Line Transaction Processing) para formar lo que se conoce como un sistema relacional de bases de datos (RDBMS). En estos sistemas se utilizan estructuras de datos conocidas como tablas (las cuales representan entidades del problema), formadas por columnas (que representan los atributos) y filas (que representan finalmente los registros de datos almacenados en la base de datos). El lenguaje de consulta es SQL (normalmente) y este permitirá realizar transacciones de datos generales contra el RDBMS para agregar datos, modificarlos, borrarlos y consultarlos de vuelta.
Por otra parte, los sistemas de bases de datos NoSQL representan un caso novedoso de almacenamiento de datos donde estos se almacenan, no de la forma tradicional estructurada del caso de los RDBMS, sino que más bien en forma desestructuradas o semiestructuradas; esta propiedad les otorga la categoría de bases de datos no-estructuradas o no-relacionales, donde las formas normales no operan completamente, permitiendo manejar grandes cantidades/volúmenes de datos y realizar, con mayor facilidad, análisis de tiempo real y almacenamiento distribuido
OLAP
A diferencia de las bases de datos RDBMS antes mencionadas, los otros tipos de almacenes de datos (sean data warehouses, data marts o data lakes) trabajan en el modo OLAP, o de procesamiento analítico, donde es útil desestructurar los datos y romper muchas veces las formas normales utilizadas comúnmente en el modo de procesamiento OLTP. Estos sistemas generalmente operan no sobre tablas de datos, sino que sobre otras estructuras de datos denormalizadas, conocidas con el nombre de tablas de dimensión y tablas de hechos. Las tablas de dimensión representan las entidades a analizar, mientras que las tablas de hechos representan todas las actividades involucradas en las tablas de dimensión. A la larga, se necesitará algún tipo de metodología que permita unir y transferir datos de tablas relacionales normales hacia las tablas de un data warehouse o un data mart; esto se logra mediante los esquemas, tales como el esquema estrella o el copo de nieve, particularmente usados al respecto.
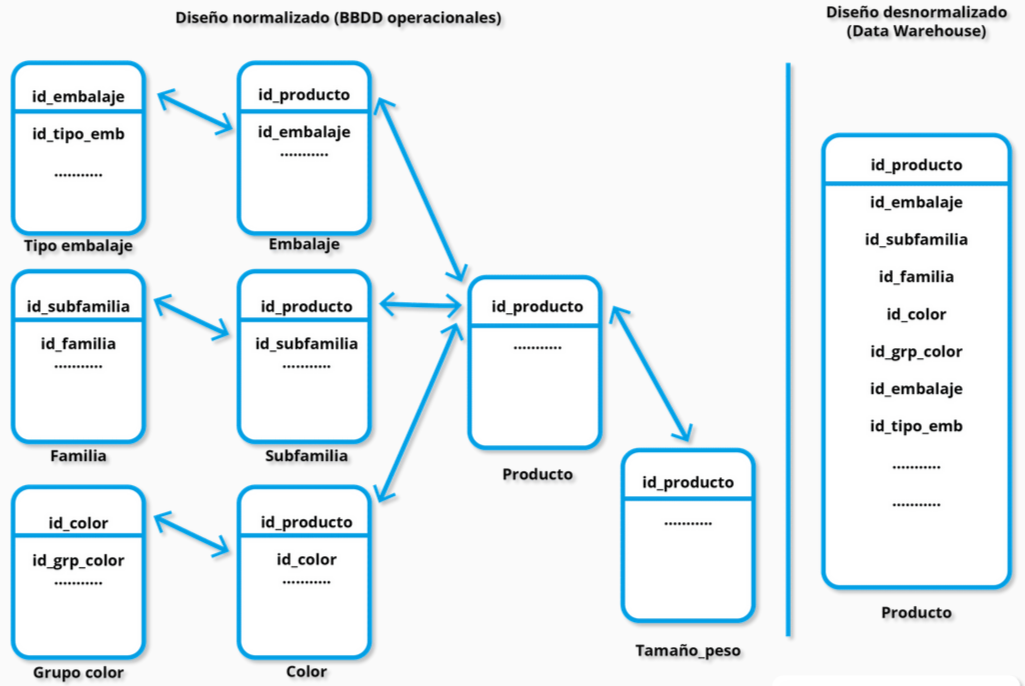
Dimensiones OLAP
Las dimensiones, que en un sistema OLAP pueden llegar a ser muy numerosas, permitirán constituir una estructura final de datos denominada como cubo OLAP (en analogía a las tablas de los RDBMS originales), pero considerando que pueden llegar a tener más de dos dimensiones. Los datos hacia estos cubos serán enviados debido al procesamiento analítico, o procesamiento OLAP, a lo largo de una serie de etapas que irán tomando los datos transaccionales originales, de los cuales las más generales son los siguientes
-
Etapa o tecnología ETL (extract-transform-load), que leerán datos transaccionales, los transformará a una representación adecuada (mediante concatenaciones de datos, cálculos y otras operaciones) y correspondiente a las dimensiones a cargar en los cubos OLAP, para luego cargar dichos datos en la base de datos del data warehouse o data mart.
-
Etapa o tecnología ELT (extract-load-transform), similar a la tecnología antes explicada, pero dejando la subetapa de transformación al mismo data warehouse para que sea realizada de forma interna, con sus herramientas propias.
-
Uso de herramientas para generación y recolección de metadatos.
-
Uso de herramientas de gobernanza de datos, que permite asignar encargados sobre los datos para su revisión y corroborar su veracidad e integridad.
batch processing vs streaming processing
Finalmente, dentro de la descripción del procesamiento ETL o ELT, es bueno recordar que no siempre los datos estarán disponibles exactamente en el momento en que se necesiten utilizar, ni menos estarán preparados con la estructura esperada o el formato correcto. Para subsanar estas incertidumbres, los procesos ETL o ELT descritos deberán ser ejecutados en periodos de tiempo predeterminados y preprogramados, o bien, a medida que los datos vayan entrando al sistema de data warehouse; la primera modalidad se identifica con el nombre de procesamiento por lotes o “batch processing”, mientras que la segunda modalidad corresponde al llamado procesamiento de flujos de datos de entrada o “streaming processing”
2. Arquitecturas de almacenamiento escalable
El crecimiento sostenido de los volúmenes de datos y la necesidad de mantener sistemas disponibles y eficientes han impulsado el desarrollo de arquitecturas capaces de escalar, resistir fallos y procesar grandes cantidades de información de manera distribuida. Estas arquitecturas permiten que los sistemas de datos modernos operen de forma continua, incluso ante fallos parciales o incrementos abruptos en la carga de trabajo. A continuación, se presenta, de forma general, una serie de tecnologías y arquitecturas relacionadas con la temática de los tipos de almacenamiento de datos usados en la actualidad. Adicionalmente, se describen algunos detalles más amplios relacionados con la parte técnica que define cada tecnología.
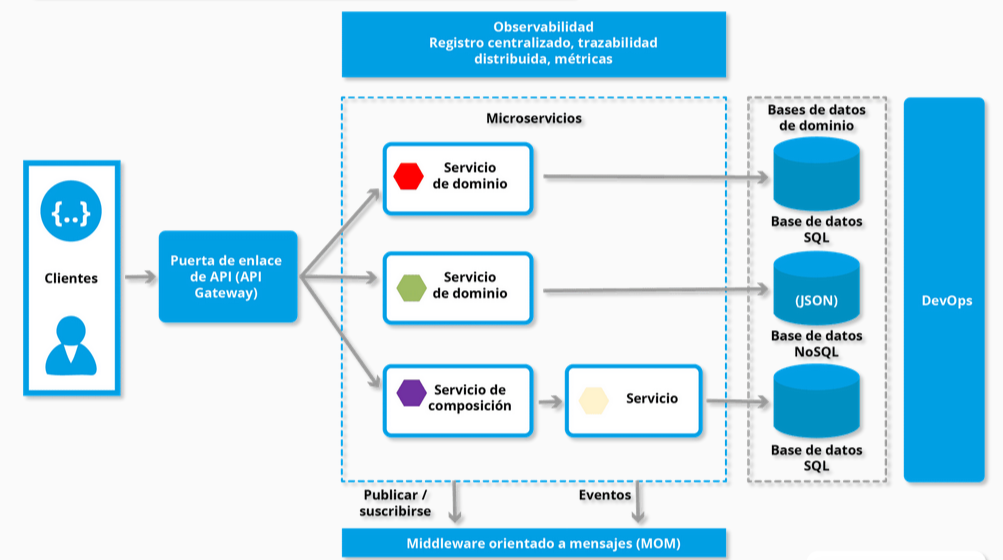
Microservicios
Los microservicios corresponden a pequeños servicios de datos, componentes de una aplicación más grande, que tienen poco código de programa, se encuentran desacoplados unos de otros y se ejecutan de forma independiente (usando hilos de ejecución o threads). En conjunto, definen una API de comunicación para el intercambio de datos.
Lambda
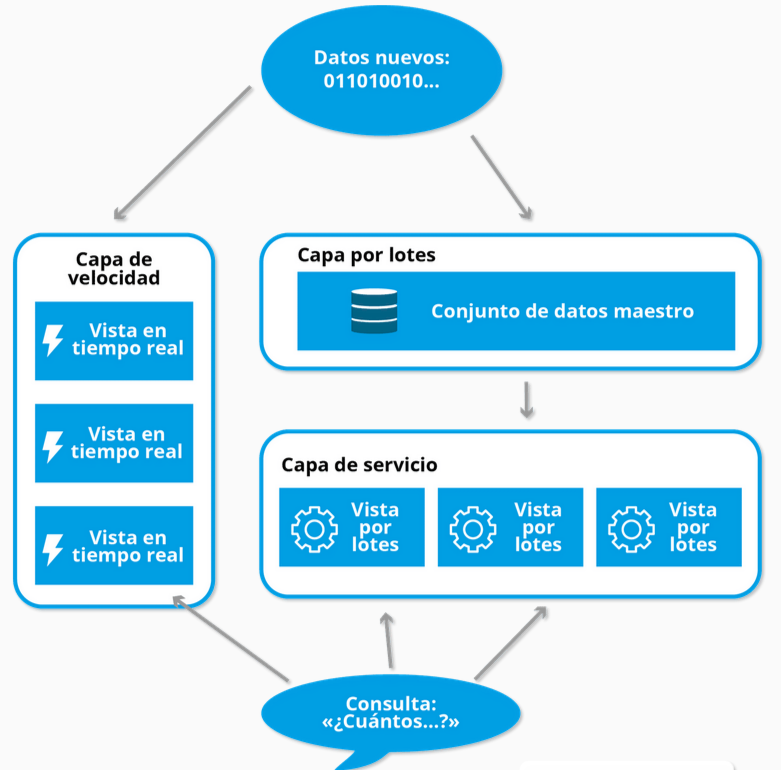
Otra arquitectura vista fue la arquitectura Lambda, ligada al mundo de análisis de OLAP. La arquitectura Lambda de Marz y Warren es muy interesante porque, a nivel técnico, ellos proponen la creación de tres capas de procesamiento (o layers).
| Capa Procesamiento | Descripción |
|---|---|
| Batch layer (Capa de procesamiento por lotes | Para procesamiento de lotes de grandes cantidades de datos a intervaloes regulares programables |
| Serving layer (Capa de servicio) | Se implementa sobre una base de datos distribuida que carga datos del procesamiento batch anterior para lograr realizar lecturas aleatorias rápidas sobre estos datos |
| Speed layer (Capa de velocidad) | Procesa datos que van entrando al sistema mientras la capa batch sigue realizando su propio proceso sobre los primeros datos |
3. Arquitecturas cloud para datos
| Arquitectura cloud | Descripción |
|---|---|
| Nubes públicas | Los recursos utilizados para la creación de la nube se redistribuyen entre todos los participantes de la nube (los inquilinos) |
| Nubes privadas | Los recursos se destinan únicamente al usuario que contrata el servicio. Esta nube puede estar creada dentro de los límites físicos de red de la organización del usuario |
| Nubes híbridas | Combinan características de los entornos de nubes públicas y privadas |
| Multinubes | Corresponden a un sistema constituído por varias nubes interconectadas entre sí |
Otro tipo de categorización importante, dado por Kuzmiakova en su libro, muestra diferentes tipos de arquitecturas cloud según su orientación al tipo de base de datos que pueden implementar. Según esto, las categorías de bases de datos de tipo cloud que se pueden implementarson las siguientes:
| Modelo | Descripción |
|---|---|
| Base de Datos como un Servicio (DBaaS) | El proveedore de servicios de la nube entrega toda la infraestructura, pero los usuarios administran sus propios recursos utilizados |
| Desarrollo basado en máquinas virtuales | Las organizaciones despliegan máquinas virtuales en la nube para luego instalar RDBMS dentro de ellas |
| Sin-servidores (Serverless) | El proveedore se preocupa de la implementación, configuración y administración, mientras que el usuario solo paga por lo que ocupa en la realidad |
| Arquitectura de bases de datos distribuida | Las bases de datos pueden localizar sus datos e infraestructura más allá de las fronteras políticas o geográficas, a veces abarcando varios continentes |