Del dato crudo a la información útil: procesos ETL en acción
1. Introducción al análisis OLAP
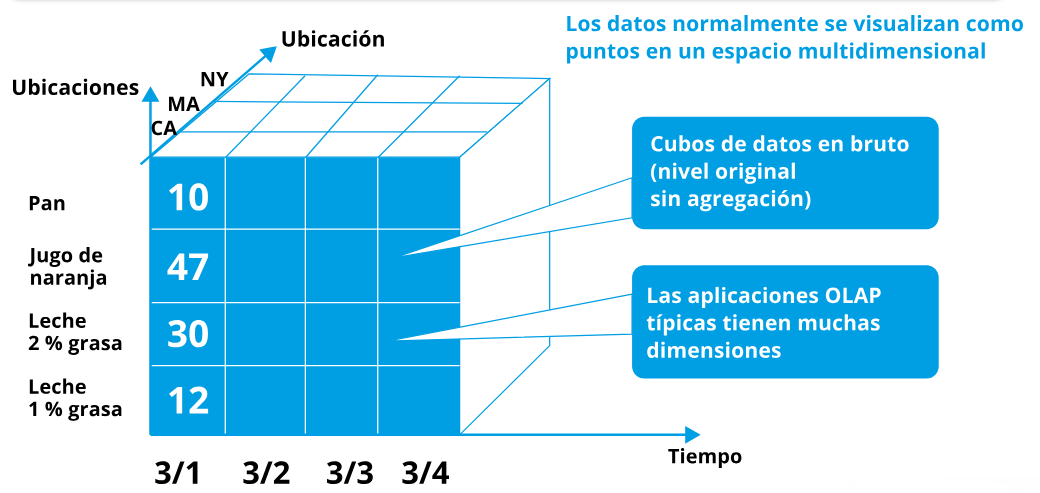
El procesamiento OLAP consiste en una tecnología que permite analizar los negocios desde diferentes puntos de vista. En este caso, el elemento básico de análisis de datos lo constituye el llamado cubo OLAP, que corresponde a una entidad de datos que puede guardar información almacenada según dimensiones, o diferentes aspectos/categorías de datos.
Las dimensiones son similares a las columnas de las tablas en un sistema de bases de datos relacional RDBMS, pero a diferencia de estas (donde las tablas de RDBMS en modo OLTP tienen solamente filas y columnas), las dimensiones en un cubo OLAP pueden ser múltiples (inclusive 3 o más), formando muchas veces lo que se denomina una estructura de hipercubo (4 dimensiones o más, como referencia a la geometría de cuarta dimensión o mayor en matemáticas).
Procesamiento tipo OLAP
| Procesamiento | Descripción |
|---|---|
| ROLAP | OLAP Relacional. El análisis se realiza con SQL sobre bases de datos relacionales (esquema estrella o copo de nieve), pero este enfoque es lento y poco optimizado para consultas multidimensionales |
| MOLAP | OLAP Multidimensional. Usa la estructura de cubo OLAP para representar datos del datawarehouse de forma multidimensional, logrando un análisis mucho más rápido que ROLAP |
| HOLAP | OLAP Híbrido. Combina las ventajas ROLAP y MOLAP seǵun las necesidades del contexto y las capacidades tecnológicas disponibles |
Arquitectura OLAP
-
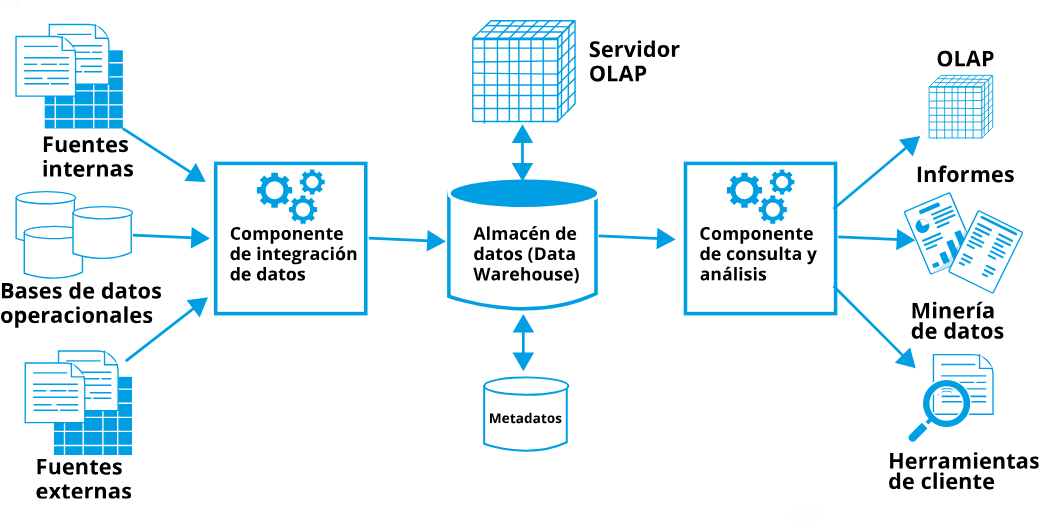
Orígenes de datos, constituídos por las fuentes internas y externas de datos, así como por datos provenientes de otros sistemas de bases de datos.
-
Un sistema intermedio, que integrará todos los datos provenientes de las fuentes descritas en el punto (1)
-
El sistema central de almacén de datos (data warehouse/data mart), unido a un servidor OLAP y a un servicio de metadatos (para etiquetar los datos analizados)
-
Otro sistema intermedio, que permitirá entregar a los usuarios una serie de servicios de consultas de datos, basado en el uso de los sistemas ROLAP/MOLAP/HOLAP
-
Finalmente, las herramientas externas de análisis y presentación de datos para los usuarios que tomarán partido de la información analizada y extraída
Análisis tipo ROLAP
Ya que se trabaja con tablas convencionales de bases de datos relacionales, será necesario definir un modelo de datos para trabajar con los datos en modo OLAP de análisis.
Esto se logra mediante el uso de los esquemas de datos estrella y copo de nieve, que dan a entender la forma en que los datos crudos de las tablas de la RDBMS serán vinculados entre sí para facilitar el modo OLAP relacional.
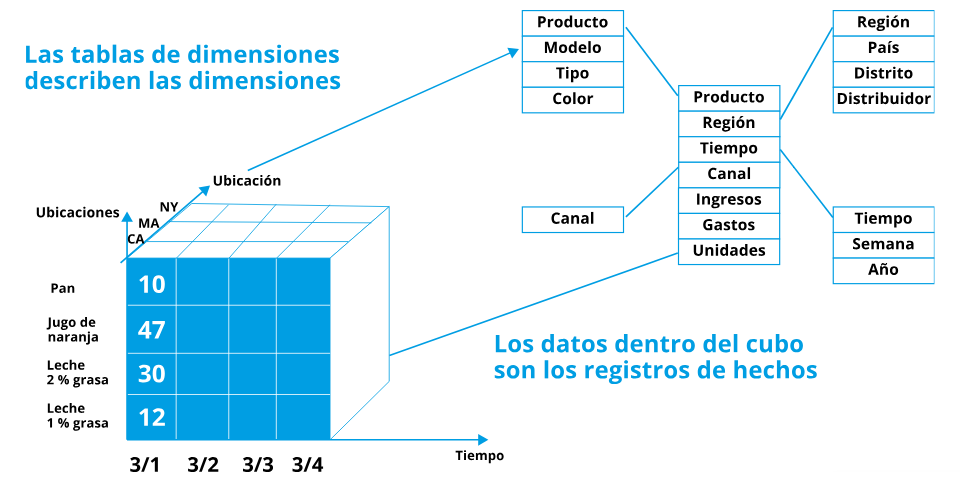
El esquema estrella (el más simple de utilizar), permitirá definir 2 tipos de tablas intermedias, las llamadas tablas de dimensiones y tablas de hechos
| Tabla | Descripción |
|---|---|
| Tabla de dimensiones | Entrega los datos crudos originales para cada categoría o dimensión considerada en el análisis OLAP |
| Tabla de hechos | Contiene los datos reales calculados y derivados, producto del análisis OLAP sobre las tablas de dimensiones |
2. Operaciones fundamentales sobre cubos OLAP
Los cubos OLAP tienen grandes ventajas sobre los esquemas relacionales de tipo estrella o copo de nieve: permiten desplegar y sumar grandes cantidades de datos sin mucho problema, porque están optimizados para tales tareas. También permiten realizar búsquedas rápidas sobre extensos conjuntos de datos y aplicar operaciones adicionales.
| Operaciones | Descripción |
|---|---|
| Rebanado (slicing) | Permite crear una visualización en 2 dimensiones a partir de un cubo OLAP, eligiendo solo un valor para alguna de las dimensiones (por ejemplo, mostrar solo los datos del año 2025 o solo los datos del mes de junio). Esto permitirá crear hojas de cálculo y visualizaciones para análisis más simples que las entregadas por el cubo OLAP completo |
| Corta (dicing) | Permite obtener un subcubo OLAP más pequeño a partir de uno más grande, eligiendo solo las dimensiones necesarias para el análisis actual |
| Excavar (drill-through) | Permite obtener los datos relacionales originales que conformaron al cubo OLAP actual |
| Profundizar (drill-down) | Permite tomar un cubo OLAP y ver detalles internos dentro de él. Por ejemplo, si un cubo tiene información demográfica sobre un país, la operación de profundización permitirá ver la misma información, pero sobre regiones y distritos, luego por ciudades, por comunas, etc. |
| Consolidación (roll-up) | Permite resumir los datos del cubo OLAP de acuerdo con atributos específicos. Es la operación opuesta a la profundización (drill-down) |
| Pivotear/rotar (pivot) | Permite cambiar de lugar las dimensiones de un cubo OLAP para tener diferentes perspectivas de visualización de los datos |
3. Recolección de datos mediante el proceso ETL
Para lograr obtener datos del negocio y aplicarlos hacia un sistema de almacén de datos (data warehouse), se hace necesario tomar los datos desde diferentes orígenes de datos:
-
Bases de datos relacionales convencionales, como MySQL/MariaDB, Oracle 11, PostgreSQL, MS SQL server, etc.
-
Bases de datos NoSQL, como MongoDB, Apache Cassandra, Apache HBase, Redis, etc.
-
Archivos de texto o de diferentes tipos (pdf, csv, binarios, etc.)
-
Flujos de datos en tiempo real
-
Datos de otros data marts o data warehouses, etc.
En los sistemas de data warehousing y de data lakes se opera con un tipo de proceso denomidado ETL (extract-transform-load), que está compuesto por las siguientes etapas:
| Etapa | Descripción |
|---|---|
| Extracción de datos | El sistema ETL se conecta a distintas fuentes de datos (SQL, NoSQL, archivos CSV, XML, JSON, etc.) mediante drivers y bibliotecas (ODBC, JDBC, entre otros) para extraer los datos necesarios para el cubo OLAP. |
| Transformación de datos | La etapa más compleja del ETL: consiste en adecuar los datos extraídos para incorporarlos al cubo OLAP. Puede ir desde trasladar datos en su forma original, hasta aplicar filtros, eliminar registros inválidos, concatenar campos, calcular hashes, cifrar o reestructurar datos. |
| Carga de datos | Los datos transformados se cargan en la tabla de hechos o el cubo OLAP, actualizando la información disponible para el análisis |