Automatizando la integración de datos con Pentaho
1. Fundamentos conceptuales del proceso ETL
La automatización de la integración de datos se apoya en la comprensión de los principios que rigen el proceso ETL, el cual constituye el eje central para trasladar datos desde múltiples fuentes hacia los sistemas analíticos. Este proceso permite consolidar información heterogénea, prepararla de acuerdo con criterios definidos y disponerla en repositorios diseñados para el análisis, garantizando coherencia y confiabilidad en los datos utilizados por las organizaciones.
El proceso ETL se estructura en tres fases fundamentales que definen su lógica de funcionamiento. En primer lugar, la extracción se encarga de obtener los datos desde los sistemas de origen, los cuales pueden corresponder a bases de datos, archivos u otros sistemas de información. En esta fase, los datos se recopilan respetando su formato y estructura original, con el objetivo de trasladarlos hacia un entorno donde puedan ser procesados de manera controlada.
Posteriormente, la fase de transformación permite preparar los datos mediante tareas de limpieza, validación, conversión de formatos, aplicación de reglas de negocio y cálculos necesarios para su análisis. Esta etapa resulta crítica, ya que en ella se asegura la calidad, consistencia y compatibilidad de los datos con los modelos analíticos utilizados. Finalmente, la carga consiste en almacenar los datos transformados en los repositorios analíticos correspondientes, como data warehouse o data mart, donde quedan disponibles para su explotación mediante herramientas de análisis.
Uno de los principales aportes del proceso ETL es la mejora de la calidad de los datos utilizados en los sistemas analíticos. A través de la identificación y corrección de errores, duplicidades e inconsistencias, el proceso ETL permite disponer de información confiable para apoyar la toma de decisiones. En este sentido, ETL no solo cumple una función técnica, sino también estratégica dentro de las arquitecturas de datos modernas.
Comprender estos fundamentos resulta indispensable para avanzar hacia la automatización de la integración de datos. Al definir claramente las fuentes, las reglas de transformación y los destinos de carga, es posible diseñar flujos de integración que se ejecuten de manera repetitiva y controlada mediante herramientas especializadas. Pentaho Data Integration se apoya en estos principios para facilitar la construcción de procesos ETL automatizados, reduciendo la intervención manual y optimizando los tiempos de procesamiento en los sistemas de análisis de información.
2. Uso de Pentaho Data Integration (PDI)
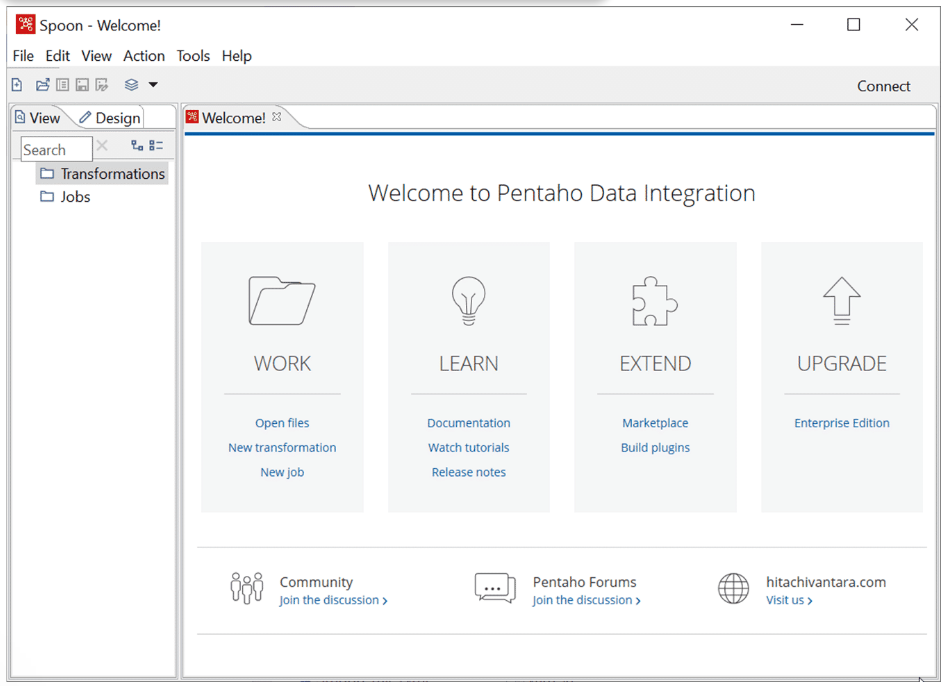
A. Ventana Principal
Transformations (transformaciones) y jobs (trabajos) son dos conceptos clave en la creación y gestión de procesos ETL dentro de Pentaho Data Integration. Las transformaciones corresponden a procesos ETL, definidos paso a paso, que determinan un flujo de datos entre fuentes de datos y receptores de datos (dicho de otra forma, entradas y salidas de datos, respectivamente). Por otra parte, los trabajos (o jobs) son conjuntos de transformaciones, que se ejecutan en cierto orden, con control de flujo y que pueden ser automatizados para realizar los procesos ETL de forma periódica y sin control directo. Esto quiere decir que lo primero que se deberá aprender es cómo crear transformaciones de datos, para luego integrarlas en trabajos que puedan ejecutarse de forma automatizada y ordenada.
B. Nueva transformación
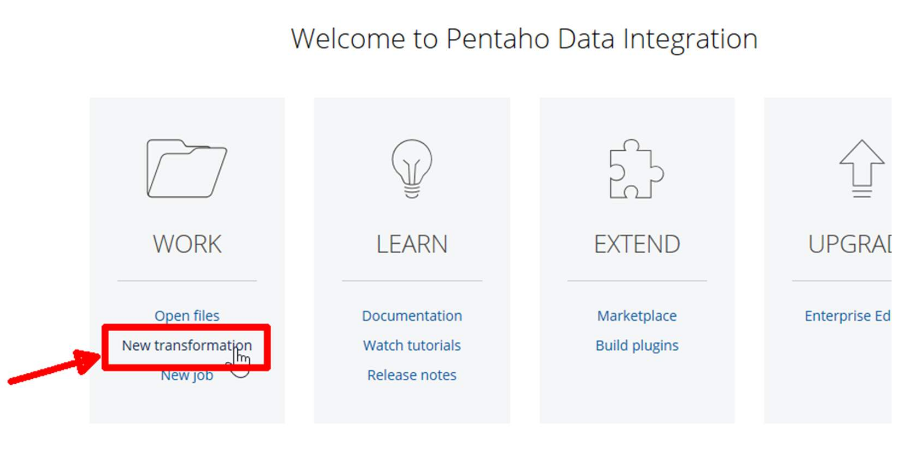
Para crear una nueva transformación, selecciona la opción de New transformation (también se pueden crear desde el menú File). Aparecerá una nueva pestaña dentro de Spoon, mostrando un área amplia donde se podrán arrastrar componentes útiles para el proceso de ETL.
C. Pasos de transformación
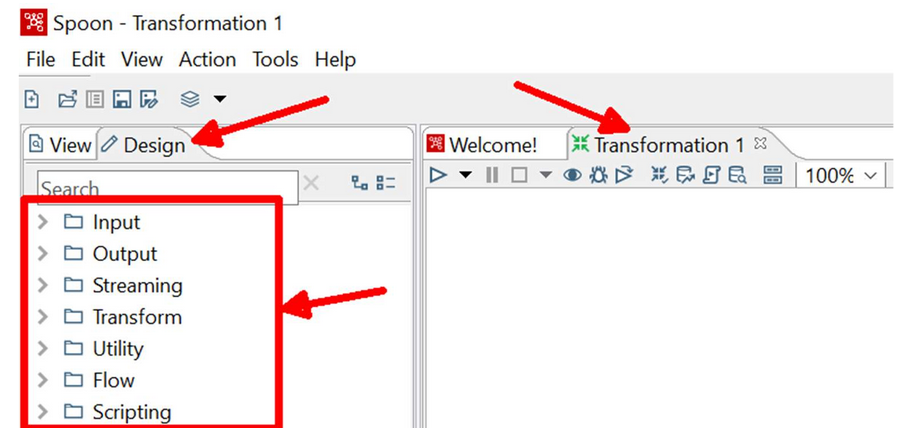
Una transformación en Spoon consta de uno o más pasos. Normalmente el primer paso corresponderá a la lectura de datos desde una fuente de entrada.
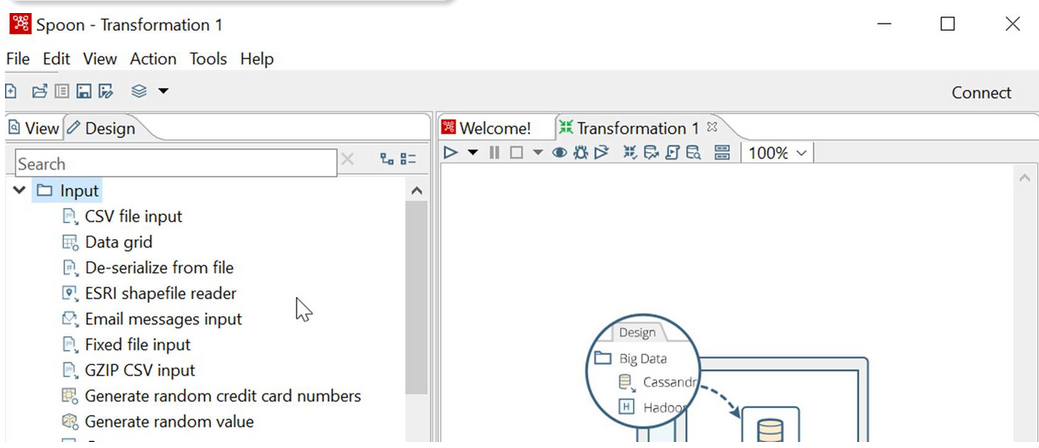
Los siguientes pasos continuarán con las transformaciones de datos y formatos de datos; finalmente, se deberían guardar los datos resultantes en algún tipo de elemento de salida.
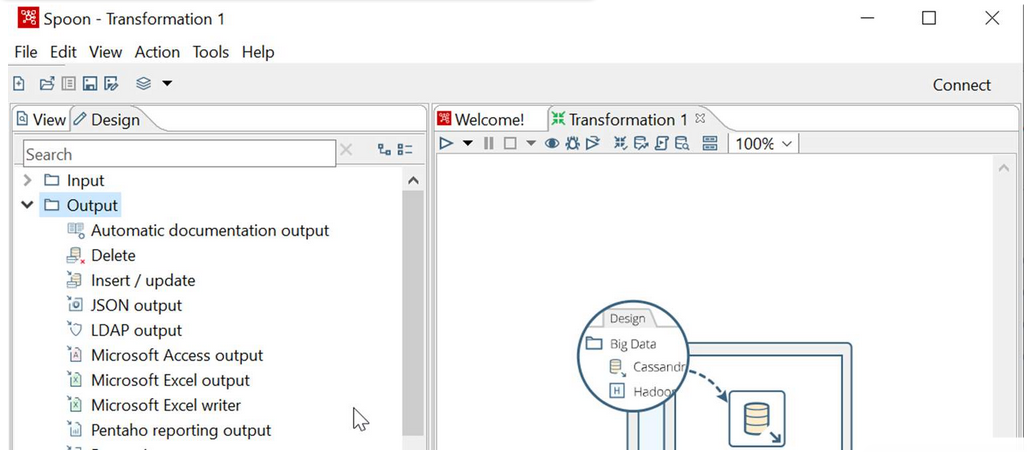
Spoon muestra diferentes categorías de pasos en el panel izquierdo, todos divididos según propósito. La categoría Input muestra diferentes tipos de fuentes de datos (archivos CSV, tablas de datos, conexión a motores de bases de datos, archivos de texto, archivos JSON y XML, etc.), mientras que la categoría Output muestra elementos que pueden recibir y guardar datos (nuevamente, archivos de texto, de tipo CSV, JSON, XML, bases de datos, etc.) Por lo tanto, se puede ver que PDI es muy flexible a la hora de trabajar con diferentes tipos de plataformas y formatos de datos.
También puede observarse que hay otras categorías de pasos, como las categorías Transform, Lookup, Scripting, Utility y otras que permiten realizar los pasos de transformación sobre los datos. Como estas categorías contienen tantos tipos diferentes de pasos, no te sientas abrumado acerca de aprenderlos todos, pero, al conocer unos cuantos, te permitirá aprender los demás de manera progresiva. Nota que hay decenas de ellos disponibles en PDI (aunque no es necesario conocerlos todos).
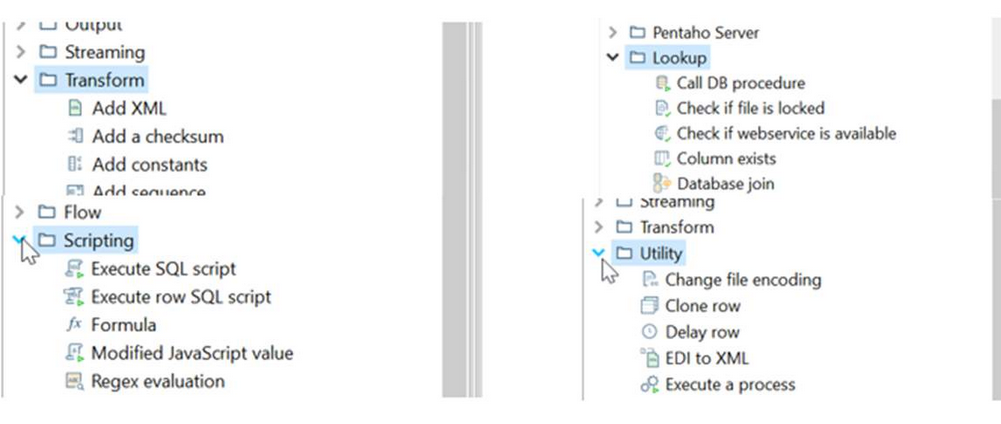
D. Agregar pasos ETL a la transformación escogida
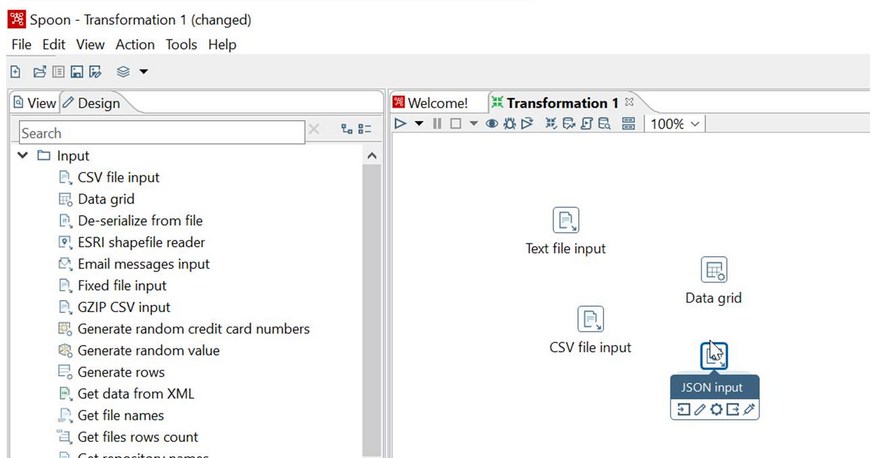
Para esto, arrastra el o los componentes que necesites hacia el área de diseño. Al arrastrar los componentes del panel izquierdo (panel Design) hacia el área de diseño a la derecha, cada componente mostrará su nombre, un ícono y un pequeño panel de herramientas (útil para el momento donde se tenga que conectar un paso con otro).
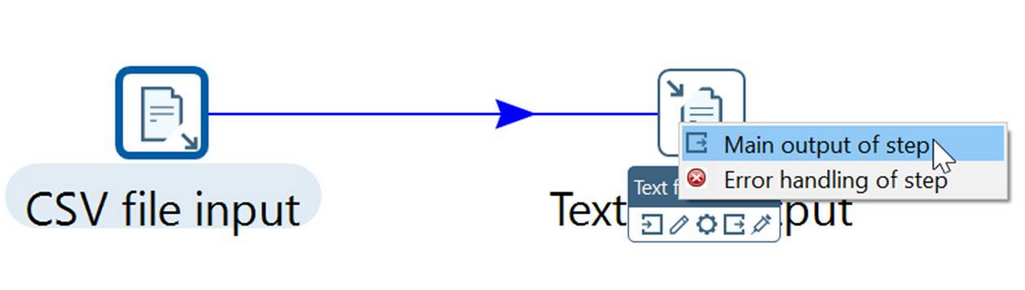
La conexión de un paso con el siguiente se conoce con el nombre de hop (salto). Para conectar un paso con otro se hace lo siguiente: deje el cursor un par de segundos sobre el primer paso para que aparezca la minibarra de herramientas; luego, arrastra el cursor del mouse desde el ícono con un marco cuadrado y una flecha saliente hacia el próximo paso a conectar. Así, se dibujará una flecha, indicando el sentido de circulación de los datos en el proceso ETL (también se puede hacer la conexión arrastrando con el botón medio del mouse presionado).
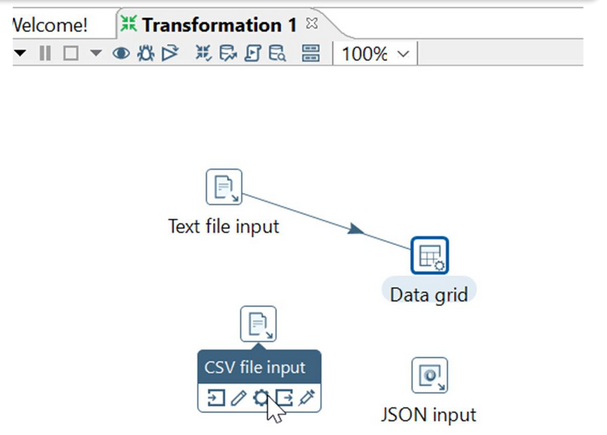
Si aparece un pequeño cuadro de selección para indicar la conexión final, normalmente deberás seleccionar la primera opción (que dice “Main output of step”), indicando que deseas manejar el salto para envío de datos y no para manejar errores (no aún).
3. Ejemplos prácticos de automatización ETL con Pentaho
Los ejemplos que se presentan a continuación abordan distintos escenarios de integración de datos, comenzando por procesos básicos de extracción y carga, avanzando hacia la aplicación de transformaciones y limpieza de datos, y culminando con la integración automatizada de múltiples fuentes de información. Esta progresión permite visualizar cómo se incrementa gradualmente la complejidad de los procesos ETL, manteniendo siempre una estructura clara y controlada.
- Ejemplo 1: Extracción y carga de datos desde archivospdf
- Ejemplo 2: Transformación y limpieza de datospdf
- Ejemplo 3: Integración automatizada de múltiples fuentespdf