De la arquitectura a la acción: integración y despliegue final del almacén de dato
1. Fundamentos para el despliegue del almacén de datos
El despliegue final de un almacén de datos representa la etapa en la que la arquitectura diseñada y los procesos de integración construidos se consolidan en un entorno operativo listo para el análisis. En esta fase, resulta fundamental asegurar que los datos integrados sean consistentes, confiables y estén disponibles de manera adecuada para su explotación por parte de los sistemas analíticos.
Uno de los elementos clave en el despliegue del almacén de datos es la correcta integración de los procesos ETL. Estos procesos permiten que los datos provenientes de múltiples fuentes sean extraídos, transformados y cargados de forma controlada, garantizando que la información almacenada responda a los modelos definidos y a las necesidades analíticas de la organización. La automatización de estos procesos contribuye a reducir errores, optimizar tiempos y asegurar la ejecución repetitiva de las tareas de integración.
El despliegue también implica considerar el modelo de datos utilizado para el análisis. En este contexto, los esquemas orientados al análisis, como los data mart y los modelos ROLAP, permiten organizar la información de manera que facilite su consulta y exploración. Un diseño adecuado del almacén de datos asegura que las estructuras implementadas respondan a los requerimientos analíticos y soporten el crecimiento y la evolución de la información.
Asimismo, el despliegue del almacén de datos requiere mecanismos de control y validación que permitan verificar la correcta ejecución de los procesos de integración y la calidad de los datos cargados. Estos mecanismos resultan esenciales para garantizar que el almacén de datos funcione de manera confiable y pueda ser utilizado como base para la toma de decisiones.
En síntesis, los fundamentos para el despliegue del almacén de datos integran aspectos técnicos y conceptuales que permiten llevar la arquitectura analítica desde su diseño hasta su puesta en operación. Comprender estos fundamentos resulta esencial para abordar la automatización de los procesos ETL, el uso de trabajos en Pentaho y la construcción de data mart, temas que se desarrollan en las secciones siguientes.
2. Configuración de una fuente de datos en Spoon
La configuración de una fuente de datos constituye el punto de partida para cualquier proceso de integración ETL, ya que define el origen desde el cual se extraerá la información que será procesada e integrada en el almacén de datos. En Pentaho Data Integration, esta configuración se realiza mediante la herramienta Spoon, la cual permite establecer de forma clara y controlada la conexión con los sistemas de origen.
A partir de esta base, el siguiente paso en el uso de Pentaho Data Integration (PDI) consiste en aprender a enlazar una fuente de datos con un motor de bases de datos instalado en el computador. Este proceso permitirá trabajar directamente con la información almacenada y avanzar en la construcción de flujos ETL más completos.
- Instalar algún motor de base de datos en tu sistema Windows. Por simplicidad, instala MariaDB (aunque tu docente podría pedirte otro motor).
- Crea una nueva conexión y una base de datos, ambos de nombre foodmart, con usuario y contraseña de acceso root y 123456, respectivamente.
- Si instalaste MariaDB, abre el gestor gráfico llamado HeidiSQL y verifica que puedas acceder a la base de datos, crear tablas, ejecutar consultas de SQL, etc.
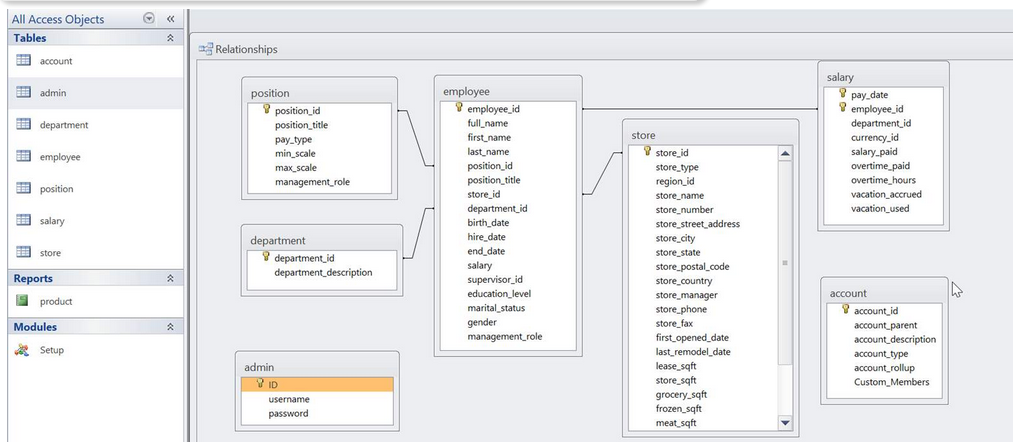
En los próximos ejercicios, se poblará la base de datos con información proveniente de otra base de datos, en Microsoft Access, de nombre FoodMart.mdb.
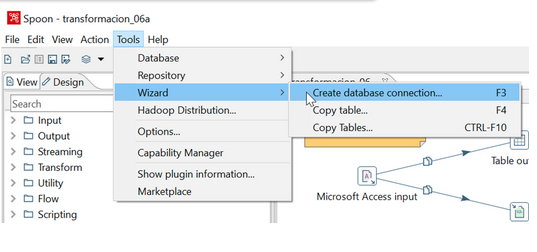
Paso 1
Primero, se crea una transformación en Spoon. Las conexiones de bases de datos se guardan sdentro de cada transformación, de forma independiente.
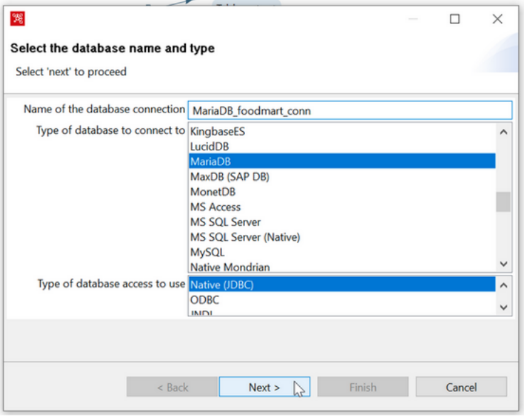
Paso 2
Selecciona el tipo de base de datos a conectar y esteblece Native (JDBC) para la conexión general.
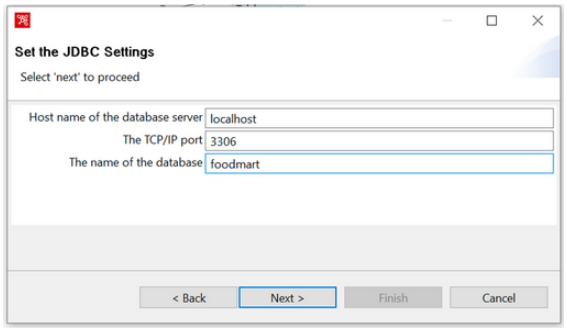
Paso 3
Configura la dirección IP (si MariaDB está en tu computador, escribe “localhost”) y el nombre de la base de datos a conectar (en este caso, foodmart)
Paso 4
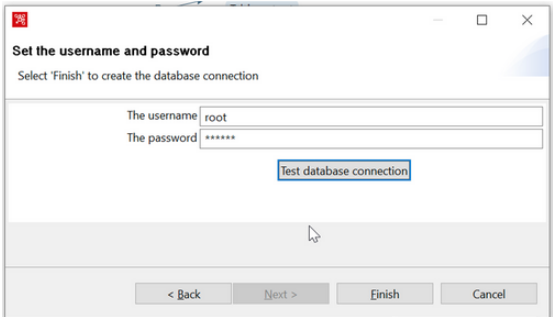
Finalmente, indica el nombre de usuario y la clave del perfil a usar para la conexión a la base de datos (en este caso, usuario root y clave 123456). Prueba la conexión de base de datos
3. Creación de trabajos (jobs) en Pentaho Data Integration
La creación de trabajos, conocidos como jobs, permite coordinar y automatizar la ejecución de múltiples procesos ETL dentro de Pentaho Data Integration.
A diferencia de las transformaciones, que se enfocan en el procesamiento directo de los datos, los trabajos cumplen la función de orquestar y controlar la secuencia de las distintas tareas involucradas en la integración del almacén de datos.
Mediante los jobs es posible definir el orden de ejecución de las transformaciones, establecer dependencias entre ellas y controlar el flujo general del proceso de integración. Esto resulta especialmente relevante cuando el almacén de datos requiere la ejecución de varios procesos ETL encadenados, los cuales deben ejecutarse de manera organizada para garantizar la consistencia y confiabilidad de la información integrada.
En este contexto, se introduce el concepto de trabajo (job) en Pentaho Data Integration. Un trabajo de Kettle corresponde a un conjunto de una o más transformaciones, creadas previamente en archivos independientes, que pueden ejecutarse en secuencia o en paralelo según las necesidades del proceso. Una de las principales ventajas de los trabajos es que pueden programarse para ejecutarse en intervalos de tiempo definidos o en fechas y horas específicas, contribuyendo a la automatización y eficiencia de los procesos ETL.
Hops
Un trabajo tiene normalmente un bloque o paso de inicio (llamado Start), uno o más pasos que contienen transformaciones, y uno o más saltos (hops) para indicar el orden de ejecución de las acciones en el trabajo completo.
También existen otros elementos (extraíbles desde el panel izquierdo de Spoon) para regular el flujo de trabajo, gestionar errores, escribir mensajes y archivos de logging y toma de decisiones al interior de un trabajo.
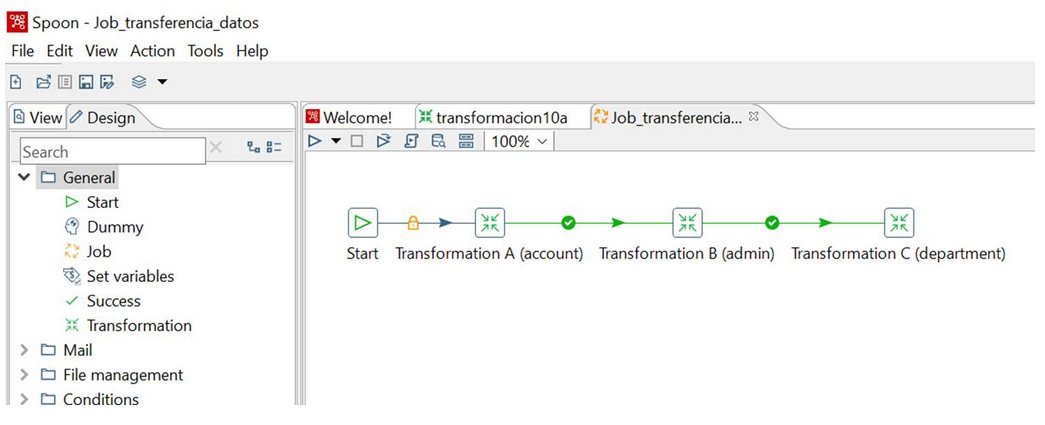
En la figura 6 se observa un ejemplo de esquema de trabajo en la interfaz Spoon de PDI; y puedes apreciar que todos los saltos (hops) tienen un ícono asociado, que puede corresponder a:
| Ícono | Descripción |
|---|---|
| Candado | Indica que el siguiente paso se ejecuta siempre, no importando si hay o no errores en el paso previo |
| Ticket verde | Indica que el siguiente paso se ejecuta si el anterior paso no tuvo errores |
| Cruz roja | Indica que el siguiente paso se ejecuta solo si el anterior paso tuvo errores. Esto permite tomar decisiones de diseño cuando ocurren errores en cierto paso del conjunto |
4. Ejemplos prácticos de integración y despliegue del almacen de datos
Los ejemplos que se presentan a continuación tienen como objetivo ilustrar de manera simplificada los procesos de carga de datos en tablas de bases de datos y su aplicación en la construcción de un sistema analítico básico. A través de estos casos, se busca mostrar cómo los distintos modos de operación pueden integrarse para dar lugar a una solución analítica funcional, apoyada en transformaciones y trabajos desarrollados con Pentaho Data Integration.
En particular, los ejemplos se orientan a la construcción de un sistema analítico de tipo ROLAP, utilizando como base la base de datos FoodMart.mdb de Microsoft Access y el motor de base de datos MariaDB como sistema RDBMS para su ejecución. De este modo, los casos propuestos permiten comprender cómo se articulan los procesos ETL y la automatización mediante trabajos en un escenario práctico de integración y despliegue final del almacén de datos.
- Ejemplo 1: Automatización del flujo ETL mediante trabajos en Pentahopdf
- Ejemplo 2: Integración del almacén de datos a partir de procesos ETL automatizadospdf
- Ejemplo 3: Despliegue final y puesta en operación del almacén de datospdf