Estadística descriptiva y correlación
Material: Cuaderno original (.ipynb)
Tercera clase de R. Con lo visto hasta aquí ya se puede analizar una tabla de datos real. Se trabajan dos temas:
- Estadística descriptiva: medidas de posición, de tendencia central y de dispersión.
- Correlación: cuánto se relacionan dos variables.
Se usan ggplot2 y los data frames, presentados en el caso práctico.
1. Los datos: mpg
mpg es una tabla de ejemplo que viene con ggplot2. Tiene 234 modelos de automóviles con su consumo de combustible. data() la carga en la sesión.
library(ggplot2)
data(mpg)
mpg
?mpg
La ayuda describe cada columna. Las que se usan en esta clase son:
cty: rendimiento en ciudad, en millas por galón.hwy: rendimiento en carretera, en millas por galón.displ: cilindrada del motor, en litros.
2. Estadística descriptiva
Medidas de posición
Las medidas de posición dividen los datos ordenados en partes con la misma cantidad de observaciones. summary() entrega el mínimo, los tres cuartiles, la media y el máximo.
summary(mpg$cty) # rendimiento en millas por galón en ciudad
quantile() calcula los percentiles que se le pidan. Con 0.25, 0.5 y 0.75 entrega los cuartiles: un 25 % de los autos rinde 14 millas por galón o menos, la mitad rinde 17 o menos y un 75 % rinde 19 o menos.
quantile(mpg$cty, probs = c(0.25, 0.5, 0.75))
Medidas de tendencia central
Indican el valor en torno al cual se agrupan los datos.
mean(mpg$cty)
median(mpg$cty)
Medidas de dispersión
Indican qué tan separados están los datos entre sí. La desviación estándar es la raíz cuadrada de la varianza; sd() la calcula directamente.
sqrt(var(mpg$cty)) # desviación estándar
sd(mpg$cty) # desviación estándar
sd(mpg$hwy) # millas por galón en carretera
Coeficiente de variación
La desviación estándar está en la misma unidad que los datos, así que no sirve para comparar variables de escalas distintas. El coeficiente de variación mide la dispersión relativa: divide la desviación estándar por la media. Suele expresarse como porcentaje y permite comparar la variabilidad de conjuntos de datos con distintas escalas o unidades.
sd(mpg$cty) / mean(mpg$cty)
sd(mpg$hwy) / mean(mpg$hwy)
El rendimiento en carretera tiene mayor desviación estándar que el de ciudad (5,95 contra 4,26), pero también una media más alta. En términos relativos, ambos varían lo mismo: cerca de un 25 %.
3. Correlación de variables
La correlación busca cuantificar el nivel de asociación que existe entre dos variables. El coeficiente más usado es el de Pearson, que toma valores entre −1 y 1:
- 1: correlación positiva o directamente proporcional. La nube de puntos sigue una recta de pendiente positiva.
- −1: correlación negativa o inversamente proporcional.
- 0: no hay relación lineal.
Seleccionar las variables
dplyr es una librería para manipular tablas. Su función select() se queda con las columnas indicadas.
library(dplyr)   # librería de manipulación de tablas
datos <- select(mpg, displ, hwy)   # hwy: millas por galón; displ: cilindrada
datos
Ver la relación en un gráfico
Antes de calcular, conviene mirar. geom_point() dibuja la nube de puntos y geom_smooth() le agrega una línea de tendencia; con method = "lm" esa línea es una recta.
ggplot(datos) + aes(x = displ, y = hwy) + geom_point() + geom_smooth(method = "lm")
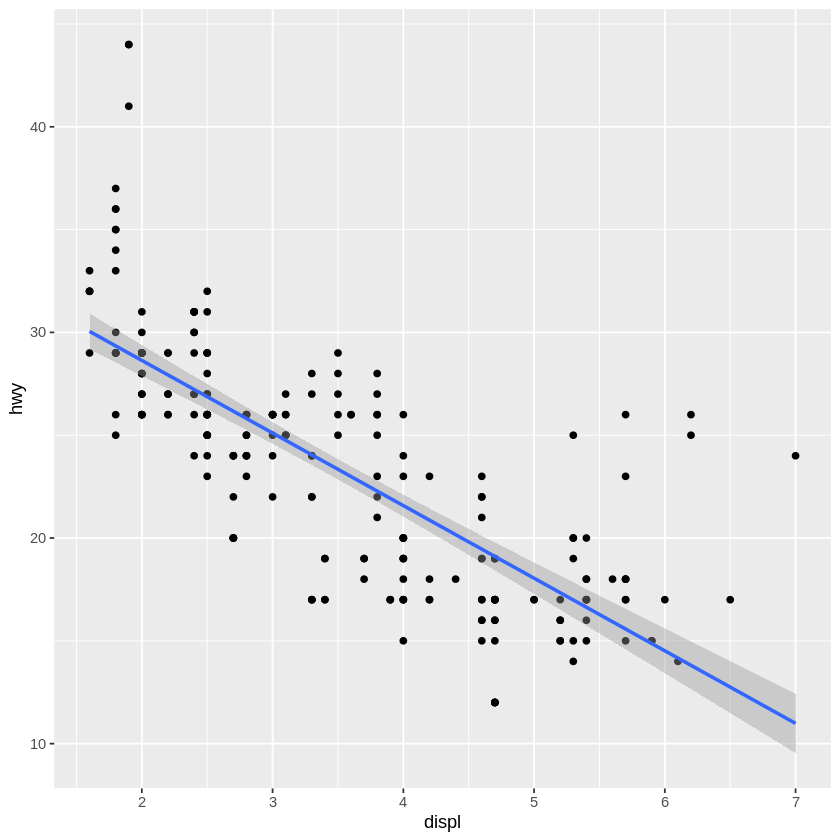
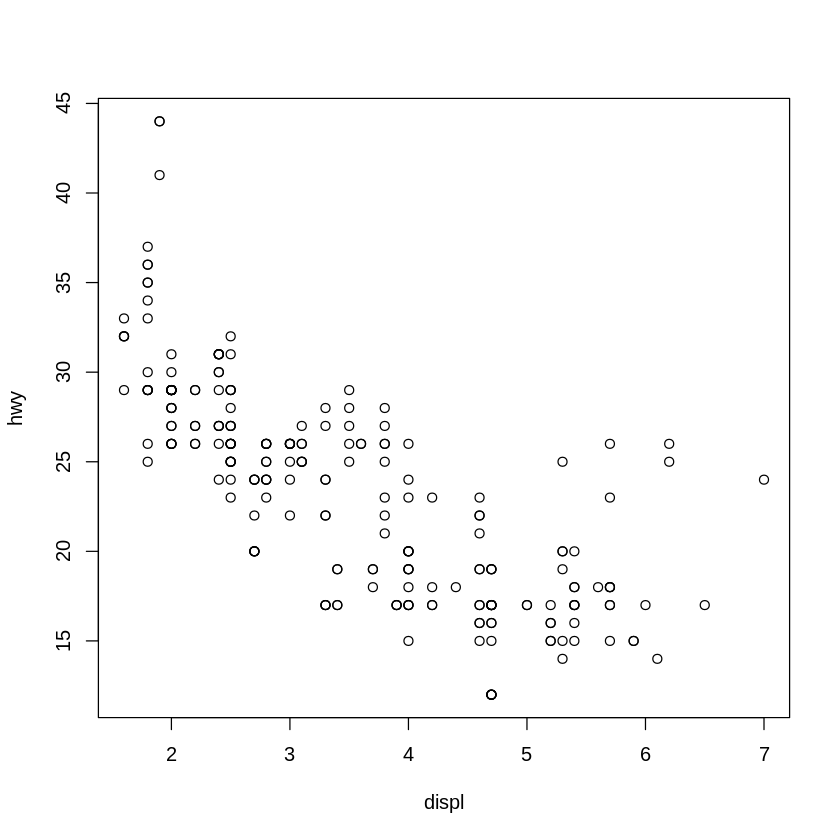
La relación es inversa: a mayor cilindrada, menor rendimiento. La banda gris en torno a la recta es su margen de incertidumbre.
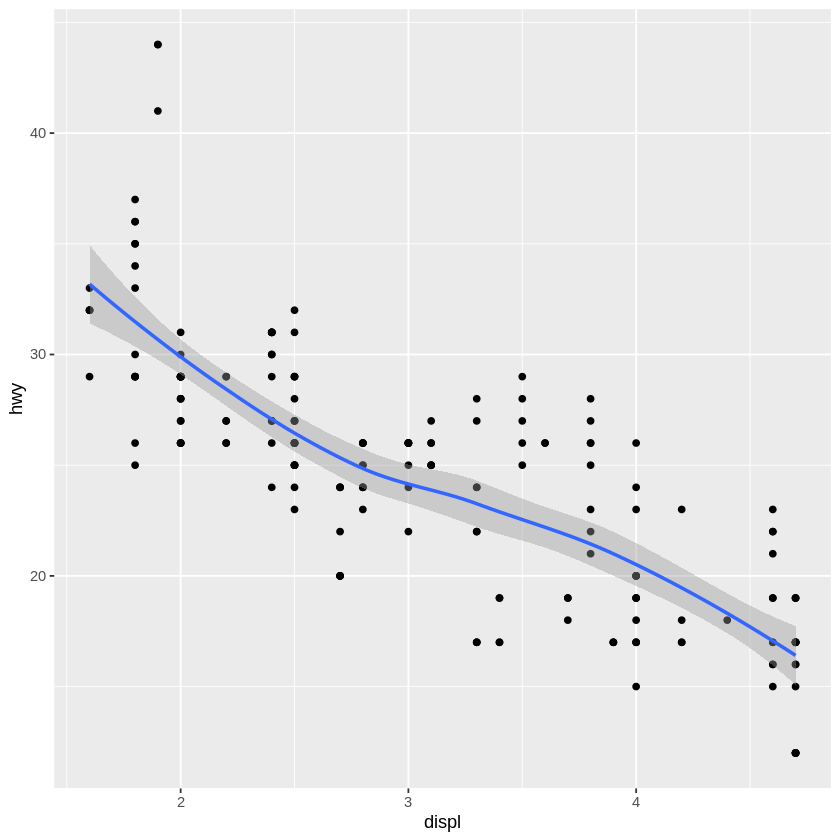
El operador %>% de dplyr encadena operaciones: pasa la tabla de la izquierda a la función de la derecha. Aquí filter() deja solo los autos de cilindrada menor que 5, y con method = "auto" la línea de tendencia deja de ser recta y sigue la forma de los datos.
ggplot(datos %>% filter(displ < 5)) + aes(x = displ, y = hwy) + geom_point() + geom_smooth(method = "auto")
Calcular la correlación
cor() sobre una tabla entrega la matriz de correlaciones: cada casilla es la correlación entre la variable de su fila y la de su columna. La diagonal vale 1 porque cada variable se correlaciona perfectamente consigo misma.
cor(datos) # Pearson
Una correlación de −0,77 confirma lo que mostraba el gráfico: una relación inversa y fuerte.
Con method se elige otro coeficiente. Spearman y Kendall no miden si los puntos forman una recta, sino si una variable crece (o decrece) siempre que la otra lo hace, aunque sea en curva.
cor(datos, method = "spearman")
cor(datos, method = "kendall")
Una relación que no es lineal
install.packages("tidyverse")
install.packages("corrplot")
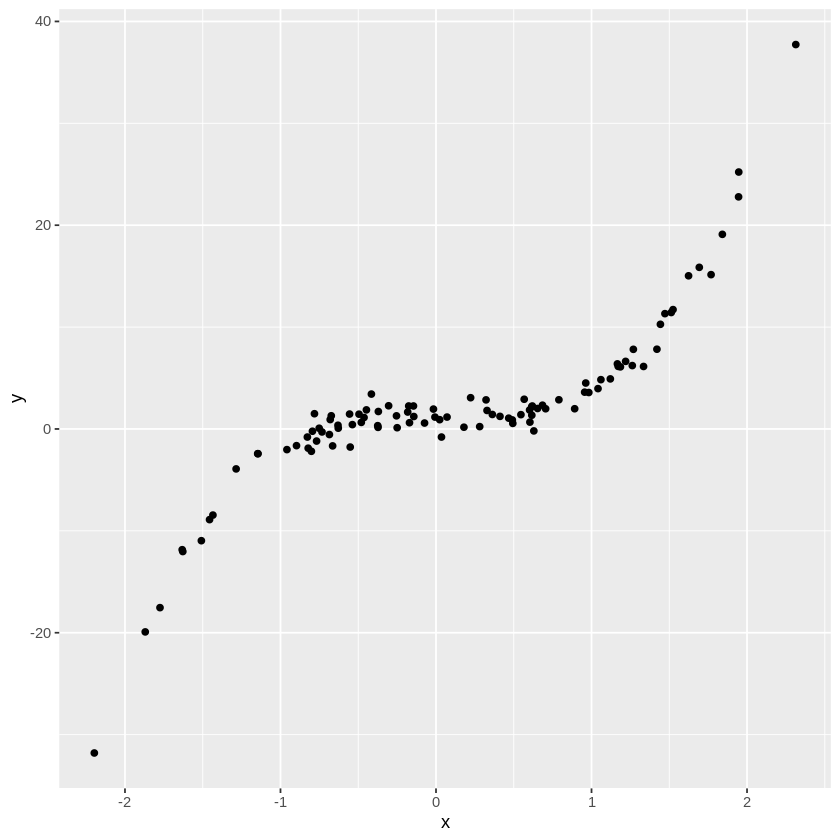
Para ver la diferencia entre los coeficientes se fabrican datos con una relación conocida. rnorm() genera números aleatorios con distribución normal (gaussiana). x son 100 de esos números, e es un ruido aleatorio y y depende de x al cubo: la relación existe, pero es una curva, no una recta.
x <- rnorm(100)
e <- rnorm(100, sd = 1)
y <- 1 + 3 * x^3 + e
A <- data.frame(x = x, y = y)
A
Como los datos son aleatorios, cada ejecución entrega valores distintos.
ggplot(A) + aes(x, y) + geom_point()
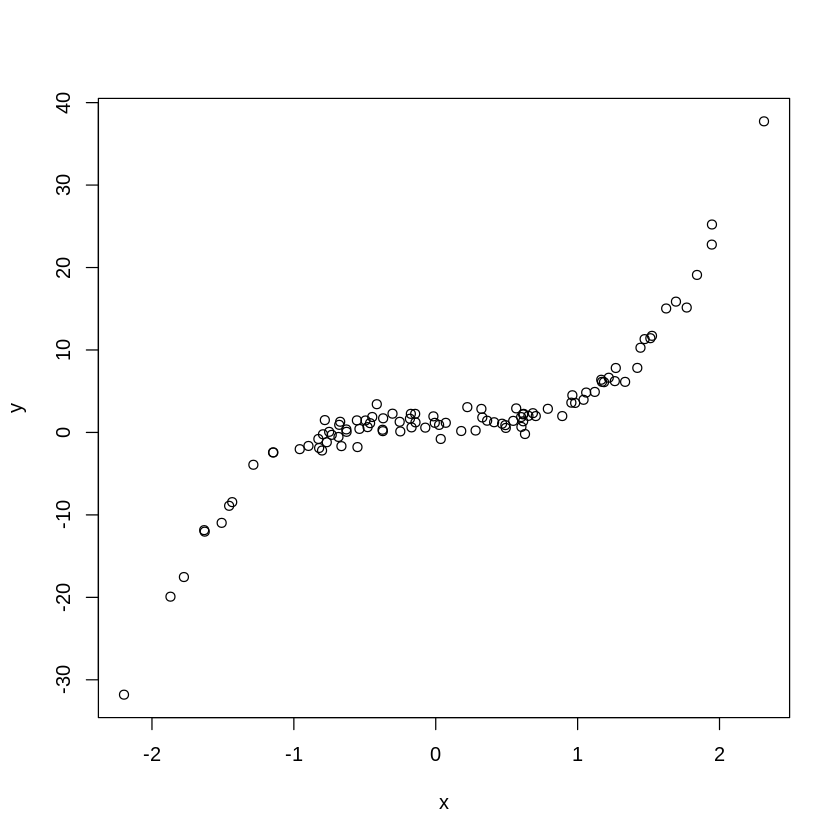
El mismo gráfico se obtiene con plot(), la función de gráficos que viene con R:
plot(x, y)
cor(x, y, method = "spearman")
Spearman da una correlación alta, 0,89, porque y crece siempre que x crece, aunque no lo haga en línea recta.
Gráfico de correlación
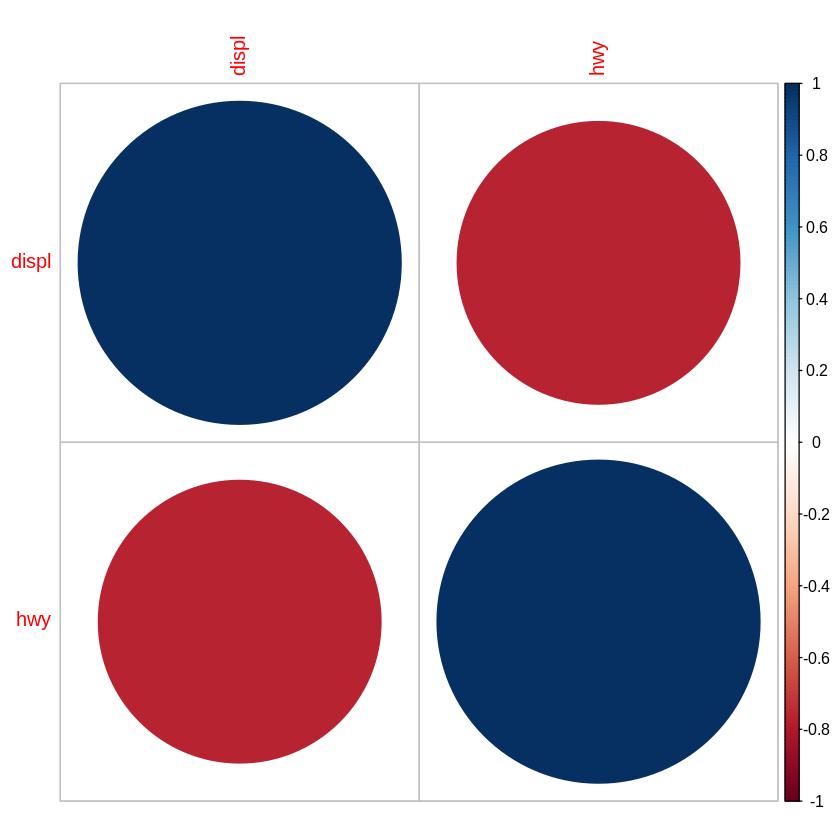
corrplot() dibuja la matriz de correlaciones. Con method = "circle", cada casilla es un círculo: el tamaño indica la fuerza de la correlación y el color su signo, azul para las positivas y rojo para las negativas.
library(corrplot)
corrplot(cor(datos, method = "pearson"), method = "circle")
Una tabla también se puede pasar directamente a plot():
select(datos, displ, hwy) %>% plot()
Tarea
Hacer un análisis descriptivo de la tabla mtcars: aplicar los comandos de esta clase, interpretar sus resultados y analizar la correlación entre sus variables. El enunciado y su solución están en la clase 11.
mtcars viene con R. Tiene 32 automóviles y 11 variables.
data(mtcars)
mtcars
?mtcars