Análisis descriptivo con R
Material: Cuaderno original (.ipynb)
Repasa con más explicación lo visto en la tercera clase: estadísticos descriptivos y correlación.
Una de las fases principales de un proyecto de ciencia de datos es el análisis exploratorio de datos. En esta etapa se hacen los primeros hallazgos, se verifica la calidad de los datos, se detectan anomalías, se identifican patrones y se plantean las preguntas clave que permiten comenzar a hacer inferencias o, si es el caso, a proponer modelos con fines predictivos.
I. Estadísticos descriptivos
- Medidas de posición: valores que permiten dividir la muestra en conjuntos con aproximadamente la misma cantidad de individuos.
- Medidas de tendencia central: valores en torno a los cuales tienden a agruparse los datos de la muestra.
- Medidas de dispersión: cuantifican el nivel de heterogeneidad de una variable numérica.
En R hay funciones para todas ellas:
| Función | Qué entrega |
|---|---|
summary() | Por defecto, estadísticos de posición (cuartiles), mínimo, máximo y media |
quantile() | Uno o varios percentiles de interés |
mean() | La media de un vector numérico |
median() | La mediana de un vector numérico |
sd() | La desviación estándar muestral |
var() | La varianza muestral |
I.1. Descripción de mpg
library(ggplot2)
data(mpg)
mpg
summary(mpg$cty)
quantile(mpg$cty, probs = c(0.25, 0.5, 0.75))
options(digits = 3) le pide a R mostrar los números con tres cifras significativas. No cambia los valores, solo cómo se imprimen: por eso los resultados que siguen aparecen más cortos que en la tercera clase.
options(digits = 3)
mean(mpg$cty)
median(mpg$cty)
sqrt(var(mpg$cty))
sd(mpg$cty)
# Coeficiente de variación
sd(mpg$cty) / mean(mpg$cty)
II. Correlación de variables
Las medidas de correlación buscan cuantificar el nivel de asociación que existe entre dos variables. Uno de los coeficientes más populares para medir la dependencia lineal entre dos variables es el coeficiente de correlación de Pearson.
Matemáticamente, el coeficiente de correlación de Pearson entre dos variables aleatorias e se define como:
Donde y son las medias y y las desviaciones estándar de cada variable. Este coeficiente varía entre −1 y 1, y alcanza esos valores extremos cuando e forman una recta.
Cilindrada y rendimiento
library(ggplot2)
data(mpg)
Al cargar dplyr, R avisa que algunas de sus funciones tienen el mismo nombre que otras que ya existían, como filter, y que desde ahora se usarán las de dplyr. Es un aviso normal, no un error.
library(dplyr) # manipular tablas
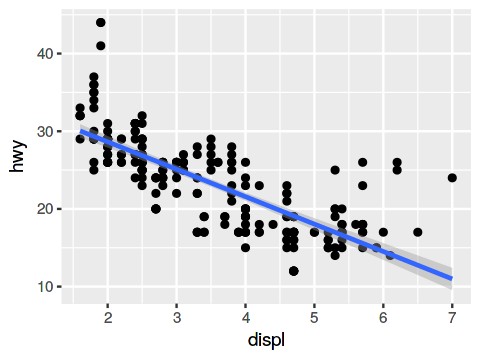
El código de un gráfico se puede escribir en varias líneas, terminando cada una con +. Las partes que están después de un # quedan desactivadas: son opciones para probar, como alpha, que hace los puntos transparentes, o geom_jitter(), que los desplaza un poco para que no se tapen entre sí.
data2 <- select(mpg, displ, hwy)
ggplot(data2) +
    aes(x = displ, y = hwy) +
    geom_point() +   #alpha=0.3)#+
   # geom_jitter()
    geom_smooth(method = "lm")
data2 <- select(mpg, displ, hwy)
ggplot(data2 %>% filter(displ < 7)) +
    aes(x = displ, y = hwy) +
    geom_point() +   #alpha=0.3)#+
   # geom_jitter()
    geom_smooth(method = "auto")
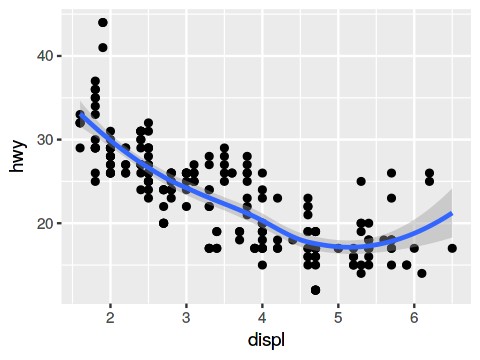
Con method = "auto" la tendencia es una curva. Muestra algo que la recta ocultaba: en las cilindradas más altas el rendimiento deja de bajar.
?geom_smooth
cor(data2)
?cor

cor(data2, method = "spearman")
#install.packages("tidyverse")

#install.packages("corrplot")
Una relación no lineal
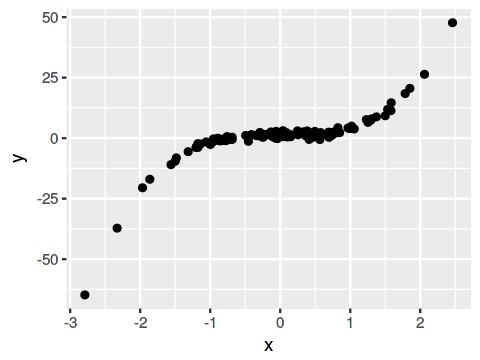
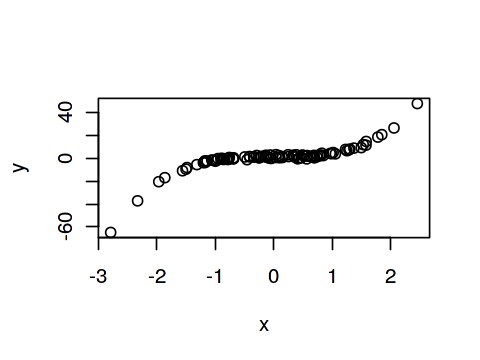
Se generan datos donde y depende de x al cubo, más un ruido aleatorio e.
x <- rnorm(100)
e <- rnorm(100, sd = 1)

y <- 1 + 3 * x^3 + e

A <- data.frame(x = x, y = y)

library(ggplot2)
ggplot(A) + aes(x, y) + geom_point()
plot(x, y)
cor(x, y, method = "pearson")
cor(x, y, method = "spearman")
Pearson, que mide qué tan cerca están los puntos de una recta, da 0,78. Spearman, que solo mide si y crece cuando x crece, da 0,88: capta mejor esta relación porque es creciente pero curva. Como los datos son aleatorios, los valores cambian en cada ejecución.
Varias variables a la vez: mtcars
library(dplyr)
library(ggplot2)
library(corrplot)
data(mtcars)
?mtcars
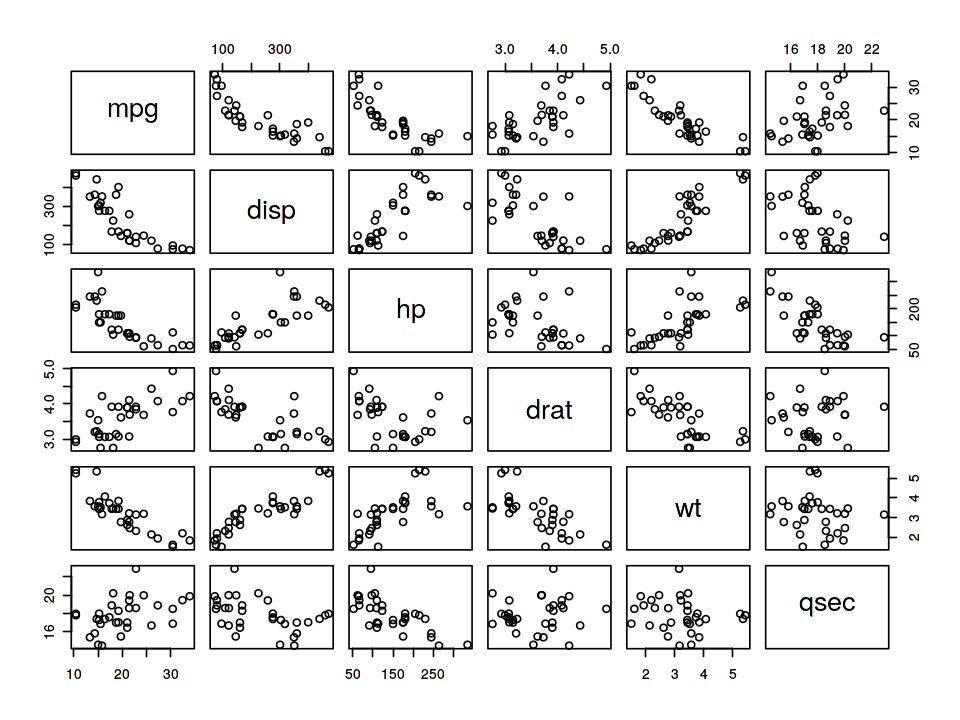
Cuando a plot() se le pasa una tabla con varias columnas, dibuja una matriz de gráficos de dispersión: un gráfico por cada par de variables. El nombre en la diagonal indica qué variable va en esa fila y en esa columna.
select(mtcars, mpg, disp, hp, drat, wt, qsec) %>% plot()
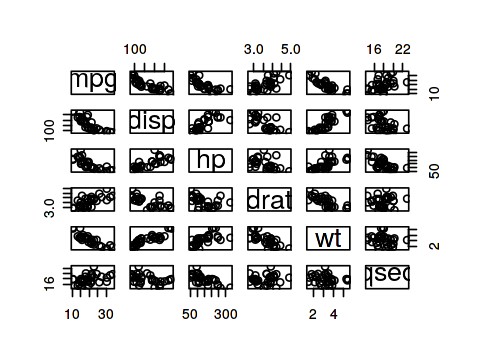
El gráfico sale apretado porque el espacio es pequeño para 36 gráficos. Las opciones repr.plot.width y repr.plot.height cambian el tamaño de los gráficos en un cuaderno; fuera de un cuaderno no tienen efecto.
# instalar repr
library("repr")
data(mtcars)
library(dplyr)
options(repr.plot.width = 8, repr.plot.height = 6)

aux <- select(mtcars, mpg, disp, hp, drat, wt, qsec)
aux %>% plot()
?mtcars
Las variables seleccionadas son mpg (millas por galón), disp (cilindrada), hp (potencia), drat (relación del eje trasero), wt (peso) y qsec (tiempo en el cuarto de milla).
P1. Comando cor
Investigar el comando cor y usarlo con la selección previa de columnas. ¿Qué se observa?
P2. Cambiar el método
De acuerdo con la documentación, cambiar el método de cálculo a "spearman". ¿Qué se observa?
cor(aux)
cor(aux, method = "spearman")
La primera matriz es la de Pearson y la segunda la de Spearman.
Qué se observa
P1. cor() entrega la correlación de cada par de variables. El rendimiento (mpg) tiene una correlación negativa fuerte con la cilindrada (−0,85), el peso (−0,87) y la potencia (−0,78): los autos más grandes, pesados y potentes rinden menos. La cilindrada y el peso se mueven juntos (0,89). En cambio, drat y qsec casi no se relacionan entre sí (0,09).
P2. Con Spearman los signos no cambian, pero varias correlaciones se hacen más fuertes: la de mpg con disp pasa de −0,85 a −0,91 y la de mpg con hp de −0,78 a −0,89. Eso indica que la relación entre esas variables es consistente pero no del todo recta, como se ve en las curvas de la matriz de gráficos.
Gráfico de correlación
library(corrplot)
corrplot(cor(aux, method = "pearson"),
         method = "circle")
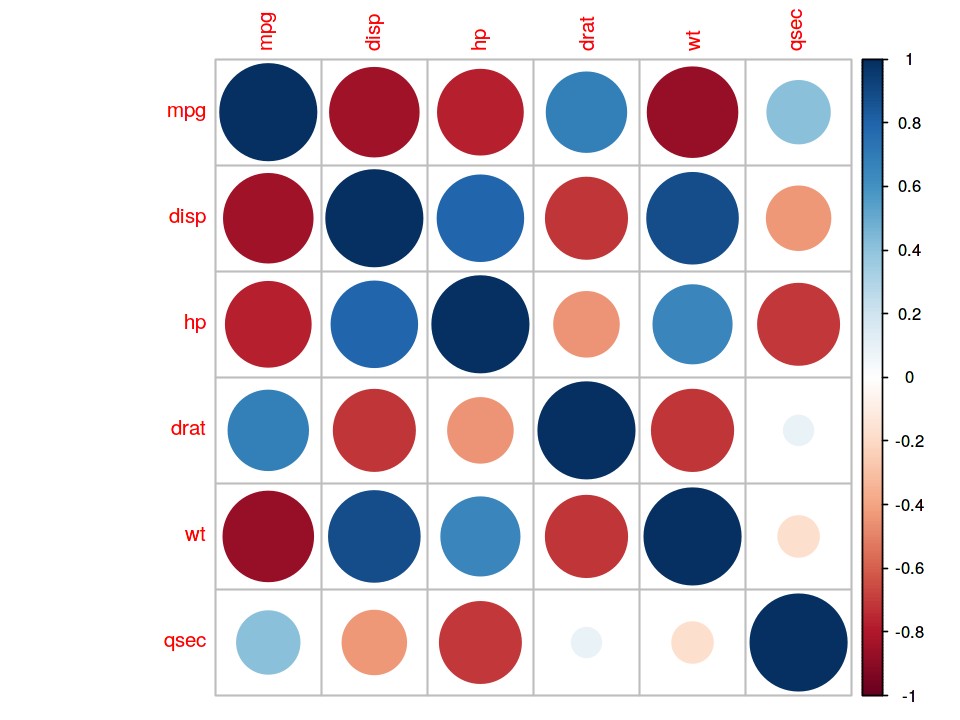
El gráfico resume la matriz de un vistazo: círculos grandes y rojos para las correlaciones negativas fuertes (como mpg con wt), grandes y azules para las positivas fuertes (como disp con wt) y pequeños y pálidos para las débiles (como drat con qsec).
P3. Opciones de corrplot
Identificar, en la documentación de la función corrplot, otros métodos de visualización.
Otros métodos de visualización
El argumento method acepta siete valores: "circle" (círculos), "square" (cuadrados), "ellipse" (elipses), "number" (el valor numérico), "shade" (sombreado), "color" (casillas de color) y "pie" (gráficos de torta).
Por ejemplo, para ver los valores:
corrplot(cor(aux, method = "pearson"), method = "number")