Regresión lineal
Material:
La correlación dice qué tan relacionadas están dos variables. La regresión lineal va un paso más allá: busca la recta que mejor describe esa relación, y con ella permite predecir el valor de una variable a partir de otras.
La variable que se quiere predecir se llama respuesta, y las que se usan para predecirla, explicativas o covariables.
1. Los datos
El archivo datos_compras.csv tiene 99 ventas de teléfonos, con la fecha, el producto, la cantidad vendida, el precio unitario y el total de la venta.
library(ggplot2)
A diferencia del archivo del caso práctico, este no viene en el formato que read.csv() espera por defecto, así que hay que indicarle:
header = TRUE: la primera línea contiene los nombres de las columnas.sep = ";": las columnas están separadas por punto y coma, no por coma.fileEncoding = "Windows-1252": la codificación del archivo, para que lea bien los caracteres especiales.
Total <- read.csv("datos_compras.csv", header = TRUE, row.names = NULL, sep = ";", fileEncoding = "Windows-1252")
head() acepta la cantidad de filas a mostrar.
head(Total, 5)
2. Un modelo con una variable
lm() (linear model) ajusta una regresión lineal. La relación se escribe como una fórmula: a la izquierda de ~ va la variable respuesta y a la derecha las explicativas. total ~ precio se lee «el total en función del precio».
mod_lm1 <- lm(formula = total ~ precio, data = Total)
Al imprimir el modelo aparecen sus coeficientes.
mod_lm1
Los coeficientes definen la recta:
- El intercepto (
(Intercept)) es el valor de la recta cuando el precio es cero. - El coeficiente de
precioes la pendiente: por cada unidad que sube el precio, el total estimado sube 1,824.
Resumen del modelo
summary() entrega el detalle del ajuste.
summary(mod_lm1)
Del resumen se puede leer lo siguiente:
| Sección | Qué muestra |
|---|---|
| Residuals | Estadísticos de posición de los residuos, es decir, de las diferencias entre cada valor real y el que predice el modelo |
| Coefficients | Los coeficientes estimados (Estimate), su error estándar (Std. Error), el estadístico t (t value), con el que se evalúa si el coeficiente es significativo, y el valor p de esa prueba (Pr(>|t|)) |
| Residual standard error | Error estándar del ajuste: la raíz cuadrada del error cuadrático medio, penalizado por los grados de libertad |
| Multiple R-squared | Porcentaje de la varianza de la respuesta que explica el modelo |
| Adjusted R-squared | Versión penalizada del anterior, que toma en cuenta posibles sobreajustes del modelo |
| F-statistic | Estadístico de la prueba F de Fisher, que evalúa si el modelo en su conjunto es significativo |
Un coeficiente se considera significativo cuando su valor p es menor que 0,05, el nivel de significancia habitual. Los asteriscos lo indican de un vistazo: mientras más asteriscos, menor el valor p.
En este modelo:
- El coeficiente de
preciotiene un valor p de 0,0003: es significativo. El precio sí se relaciona con el total. - El R cuadrado es 0,1267: el precio explica apenas un 12,7 % de la variación del total. El modelo es significativo, pero predice mal.
- Los residuos confirman que hay ventas que el modelo no logra describir: el mayor es de 6105, una venta cuyo total real superó en esa cantidad a la predicción.
3. Un modelo con dos variables
Las variables explicativas se suman en la fórmula con +. El segundo modelo agrega la cantidad vendida.
#names(Total)

mod_lm2 <- lm(total ~ cantidad + precio, data = Total)

mod_lm2
Cada coeficiente indica cuánto cambia el total estimado cuando esa variable sube una unidad y la otra se mantiene fija: 295,1 por cada teléfono adicional y 2,29 por cada unidad de precio.
4. Predecir con predict()
predict() aplica un modelo a datos nuevos. Recibe el modelo y un data frame con los valores de las variables explicativas, que deben llamarse igual que en el modelo.
Con el segundo modelo, para una venta de 4 teléfonos a un precio de 263:
test <- data.frame(precio = 263, cantidad = 4)
predict(mod_lm2, test)
Con el primer modelo, que solo conoce el precio:
test <- data.frame(precio = 263)
predict(mod_lm1, test)
Esos valores son los de la primera fila de la tabla, cuyo total real es 1052. El modelo con dos variables se equivoca por 51 y el de una variable por 100.
5. Graficar la recta ajustada
¿Cómo se agrega la recta del modelo al gráfico de dispersión? Con geom_line(), usando como altura los valores que predice el modelo. Cuando a predict() no se le entregan datos nuevos, devuelve los valores ajustados para los mismos datos con que se entrenó el modelo.
ggplot(Total) +
  aes(x = precio, y = total) +
  geom_point() +
  geom_line(aes(x = precio, y = predict(mod_lm1)), col = "red")
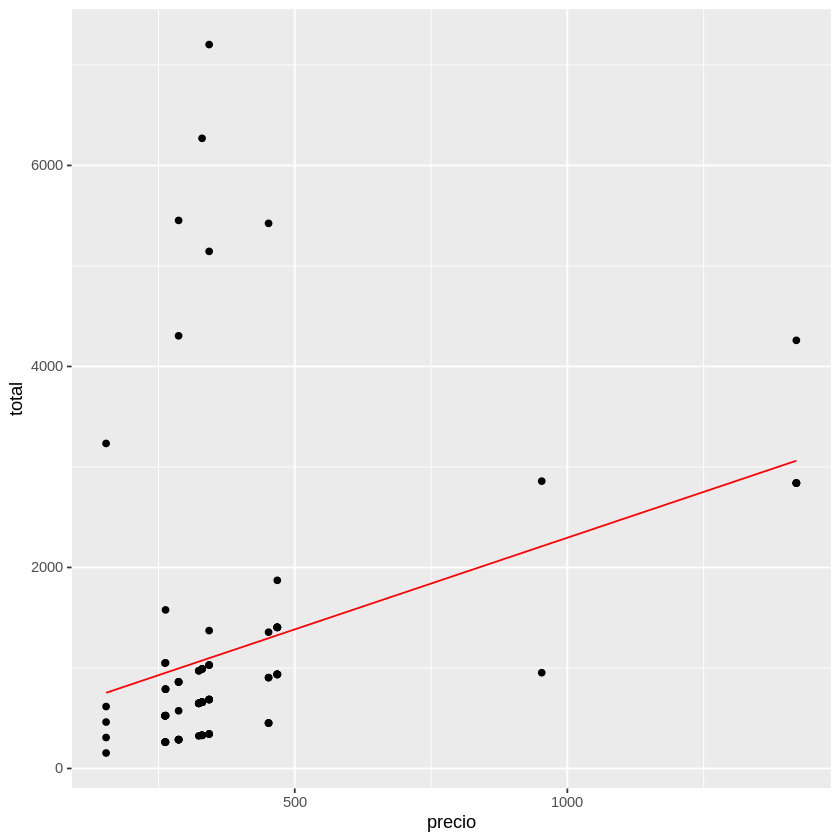
La recta sube, pero muchos puntos quedan lejos de ella, sobre todo las ventas de total alto con precios bajos. Es lo que anticipaba el R cuadrado de 0,13.
¿Y si se incluyen las demás covariables? Se repite el gráfico con el segundo modelo.
ggplot(Total) +
  aes(x = precio, y = total) +
  geom_point() +
  geom_line(aes(x = precio, y = predict(mod_lm2)), col = "red")
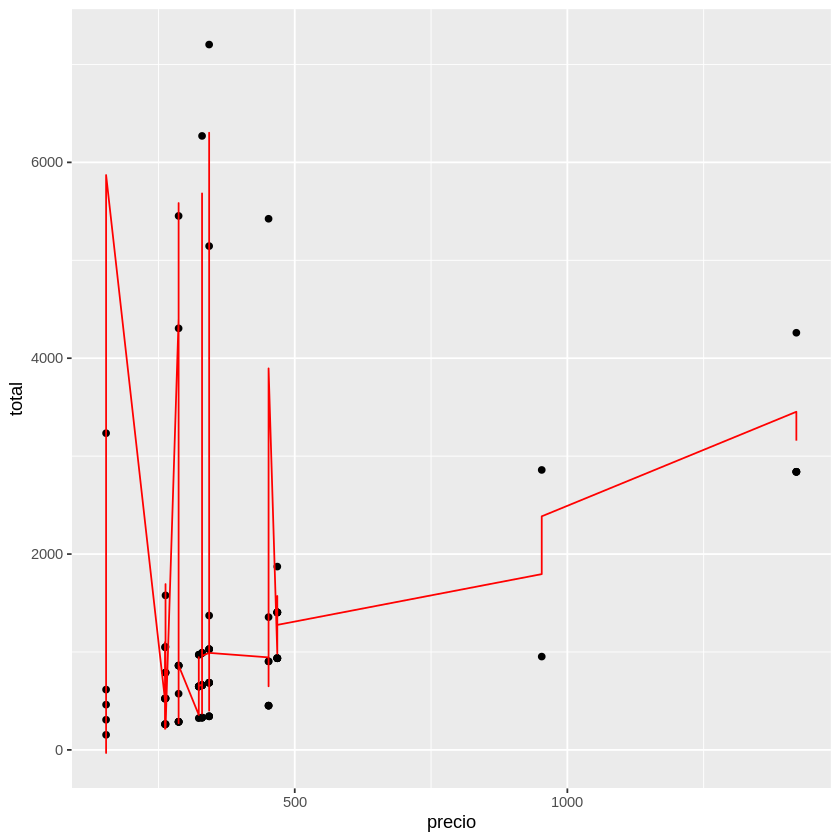
La línea ya no es una recta sino un zigzag. No es un error: el segundo modelo depende también de la cantidad, y el gráfico solo tiene el precio en el eje horizontal. Dos ventas con el mismo precio y distinta cantidad tienen predicciones distintas, y la línea salta entre ellas. Lo importante es que ahora pasa mucho más cerca de los puntos.
6. Intervalos de confianza
Los coeficientes son estimaciones hechas a partir de una muestra. confint() entrega un intervalo de confianza para cada uno: el rango donde se espera que esté el valor real, con el nivel de confianza indicado en level.
confint(mod_lm2, level = 0.95)
Las columnas 2.5 % y 97.5 % son los límites inferior y superior del intervalo del 95 %. Cada fila es un coeficiente del modelo:
- Intercepto: entre −831,86 y −525,58.
- Cantidad: entre 276,86 y 313,34. Con un 95 % de confianza, cada teléfono adicional aumenta el total entre 277 y 313.
- Precio: entre 2,00 y 2,57. Cada unidad adicional de precio aumenta el total entre 2,00 y 2,57.
Los intervalos permiten ver no solo el efecto estimado de cada variable, sino también la precisión de esa estimación: mientras más estrecho el intervalo, más precisa es. Además, ninguno de los tres incluye el cero, lo que indica que los tres coeficientes son significativos.