Laboratorio Minería de Datos
Minería de Datos · TI3V61 · Laboratorio interactivo del curso

Minería de Datos, de los datos a decisiones

Un recorrido progresivo por todo el material del curso: qué es la minería de datos, cómo se ordena un proyecto con KDD y CRISP-DM, la estadística que la sostiene, distancias y entropía, el análisis exploratorio, la limpieza, los modelos y su paso a producción. Los laboratorios trabajan con la base real IMC del curso (334 personas).

Módulos
–
Laboratorios
–
Conceptos con pop-up
–
Registros IMC
334

Toca cualquier palabra para abrir su explicación con un ejemplo real.

Red de nodos de datos conectados sobre un fondo de oficina oscura
Datos→Información→Patrones→Conocimiento→Decisiones
Avance
0/16
MÓDULO 00

Antes de empezar: la asignatura

Qué se espera de ti, cómo se evalúa y con qué herramientas se trabaja. Todo lo de este módulo proviene del descriptor oficial de la asignatura Minería de Datos (TI3V61), INACAP.

Minería de Datos es una asignatura práctica del área formativa de Especialidad de Tecnologías de Información y Ciberseguridad, dictada en modalidad semipresencial.
Al finalizarSerás capaz de aplicar herramientas y técnicas para generar conocimiento, a través de un proceso de y extracción de información, considerando la ética y la ciudadanía.
Horas totales
72
Presenciales · lab.
36
Online · asincrónicas
36
Hoja de objetivos con lápiz sobre un escritorio oscuro
Las 36 horas presenciales son de laboratorio; las 36 online son asincrónicas.
CódigoFormatoCualificaciónUCL asociadaNivel MCTP
TI3V61SemipresencialIFC304_3 · Sistemas de gestión de informaciónAdministrar el sistema de gestión de información · UC0968_3 (ajustada al contexto nacional)4

Unidades de aprendizaje

Horas presenciales (laboratorio) + online (asincrónicas)
UnidadEstrategia didácticaTécnicas
1 · Fundamentos de la minería de datosAprendizaje Basado en Proyectos (ABPro)Clase expositiva · Prácticas de laboratorio/taller
2 · Análisis estadístico y descriptivo de los datosMétodo del Caso · ABProClase expositiva · Prácticas de laboratorio/taller
3 · Procesamiento y análisis de datosMétodo del Caso · ABProClase expositiva · Prácticas de laboratorio/taller

Las horas de evaluación están incluidas en las de las unidades de aprendizaje.

Evaluación sumativa

Descriptor TI3V61
UAEvidenciaModalidad · instrumento%
1Respuestas sobre fundamentos, modelos y procesos de minería de datosIndividual · prueba escrita mixta (selección múltiple y desarrollo)15
2Informe de la ejecución práctica del proceso de limpieza de datos y de la aplicación del método descriptivo y predictivo en RGrupal · escala de apreciación35
3Informe y presentación de la ejecución práctica del análisis de datos estadísticos, en función de un caso propuestoGrupal · escala de apreciación35
1-2-3-4Evaluaciones breves online semanales en el AAI; se consideran las 5 mejoresIndividual · prueba mixta15

Además, el sistema incluye evaluación diagnóstica (inicio, conocimientos previos) y formativa (retroalimentación del avance). La fila de evaluaciones breves figura en el descriptor como UA «1-2-3-4», aunque la asignatura tiene tres unidades.

Criterios de evaluación por unidad

Descriptor TI3V61

Software estándar y bibliografía

SoftwareVersión
Pentaho CE9.3.0.0
R · Project for statistical computingR-4.3.1
RStudio2023.09.0

El material CRISP-DM/EDA del proyecto usa además Python en Google Colab, que no figura como software estándar del descriptor.

Bibliografía básicaAño
López Porrero · Limpieza de datos (Feijóo)2009
Martín Arevalillo · Problemas resueltos de iniciación al análisis estadístico de datos (UNED)2011
González Ariza · Introducción al análisis estadístico multivariado aplicado (U. del Norte)2014
Kotu · Predictive Analytics and Data Mining (Morgan Kaufmann)2014
Capri · Data mining: principles, applications and emerging challenges (Nova Science)2015
Gironés Roig · Minería de datos: modelos y algoritmos (UOC)2017
Main Yaque · Simulación con ejercicios en R (UNED)2019
Sugerida: Iryopogu · Análisis de datos con Power BI, R-RStudio y Knime (RA-MA)2021

Dónde se trabaja cada unidad en este laboratorio

Propuesta de correspondencia

Esta correspondencia es una interpretación para orientar el estudio; no forma parte del descriptor.

El enfoque del curso: cuatro perspectivas

Clase 1, Unidad I
Conceptual

¿Qué significa y para qué sirve?

Matemática

¿Por qué funciona el algoritmo o modelo?

Computacional

¿Cómo se implementa en R, KNIME u otra herramienta?

Aplicada

¿Cómo se usa en empresas y sistemas de IA?
MÓDULO 01

¿Qué es la minería de datos?

La minería de datos no es magia: es un proceso para convertir datos en patrones, modelos y decisiones.

1.1ConceptoUnidad 1

¿Cómo sabe Netflix qué serie recomendarte, Spotify qué música te gustará o un banco que una compra es fraude? Todas parten igual: con datos.

La es la disciplina orientada a descubrir patrones útiles, válidos y comprensibles en grandes conjuntos de datos. Combina , y tecnología.

Minería de Datos ≠ acumular datosMinería de Datos = descubrir conocimiento accionable.
Gráficos holográficos de barras y torta sobre un teclado
Los patrones deben poder comunicarse: sirven si alguien puede tomar una decisión con ellos.

Sí es / No es

Clase 1, Unidad I
  • ✓Formular preguntas sobre datos
  • ✓Preparar información para analizar
  • ✓Buscar patrones y relaciones
  • ✓Evaluar si esos patrones sirven
  • ✓Convertir hallazgos en decisiones
  • ✗Guardar datos sin propósito
  • ✗Hacer gráficos sin interpretación
  • ✗Ejecutar un algoritmo «porque sí»
  • ✗Confundir con causalidad
  • ✗Reemplazar el criterio humano
1.2Ejemplos realesUnidad 1

¿Dónde se usa? Elige un sector y mira el patrón que se busca y la decisión que mejora.

1.3Mapa

¿Dónde está la minería de datos entre las ciencias de la computación, la IA, el machine learning, el deep learning, la ciencia de datos y la inteligencia de negocios? Toca cada zona del mapa.

Diagrama conceptual: las fronteras son aproximadas. La primera clase pide usar estas diferencias «como mapa de conversación, no como fronteras rígidas».

ConceptoPregunta típicaResultado
¿Qué ocurrió y cómo vamos?Reportes, dashboards, KPIs
¿Qué patrones hay escondidos?Segmentos, reglas, hallazgos
¿Qué puedo predecir o automatizar?Modelos predictivos
¿Cómo aprendo de datos muy complejos?Redes neuronales profundas
BI mira el tablero; minería encuentra señales; ML construye modelos; Deep Learning es una familia potente dentro de ML. Úsalo como mapa de conversación, no como fronteras rígidas.

Línea de tiempo

Clase 1
1.4Actividad en sala

Antes de abrir código, clasifica cada problema. ¿Es , , , o ?

La pregunta esencial: ¿tengo respuesta histórica para aprender (etiqueta), quiero un número, o necesito descubrir estructura?
Aciertos
0 / 8
MÓDULO 02

Los datos: del dato a la sabiduría

No todos los datos valen lo mismo ni se procesan igual. Antes de analizar, identifica qué tipo de dato tienes.

2.1Pirámide informacional

«23», «Pedro», «15/08». ¿Esto tiene significado? No necesariamente: son piezas sueltas. Sube por la pirámide y mira cómo se agrega valor.

La minería de datos trabaja principalmente en los niveles de información y conocimiento. La sabiduría sigue dependiendo del juicio humano, el contexto y la ética.

¿Por qué dos empresas con los mismos datos pueden decidir cosas distintas?

Porque el valor no está solo en el dato: está en la pregunta, el método, la interpretación y la acción.

2.2Tipos de datosCriterio 1.1.1

Un CSV de ventas no se procesa igual que imágenes médicas o una colección de tweets.

Según su estructura los datos son , o . Un proyecto real suele combinar los tres.

Portátil con código en pantalla
Cada tipo pide herramientas distintas: SQL, MongoDB/Elasticsearch o técnicas de NLP.

Mismo registro, tres formas


Registro tomado de la fila 1 de la base IMC del curso. Las formas JSON y texto son ilustrativas.

Clasifica estos datos

2.3Tipos de variablesCriterio 1.1.1

Cada columna de una tabla es una variable, y su tipo decide qué cálculos y qué gráficos tienen sentido. Calcular la media del sexo no tiene sentido; la mediana de la clasificación sí.

El árbol de tipos · toca cada tipo

Las 8 columnas de la base IMC · toca una

Clasifica las variables del caso telecomunicaciones (Guía, ejercicio 1) y de la base IMC

Aciertos
0 / 10

Numéricas y categóricas: Guía U1 (ejercicio 1) y PDF EDA («usar media con categóricas»). La subdivisión nominal / ordinal / discreta / continua es la clasificación estándar de escalas de medición, no desarrollada en el material.

2.4Tipos de gráficosBase IMC

El gráfico se elige según el tipo de variable y la pregunta. Cada ejemplo usa los datos reales de la base.

¿Qué gráfico uso?

Quiero ver…VariablesGráfico
Cuántos casos hay por categoría1 categóricaBarras (torta solo con pocas categorías)
La forma de una distribución1 numéricaHistograma, densidad
Centro, dispersión y atípicos; comparar grupos1 numérica (± 1 categórica)Boxplot
La relación entre dos medidas2 numéricasDispersión (scatter)
La composición de una categoría dentro de otra2 categóricasBarras apiladas
Una evolución o tendencia ordenada1 numérica según tiempo u ordenLíneas
Todas las correlaciones a la vezVarias numéricasHeatmap

Histograma, KDE, boxplot, barras, scatter, heatmap y buenas prácticas: PDF «CRISP-DM y EDA», pasos 6 a 8 y 11. Torta, barras apiladas y líneas: complemento.

MÓDULO 03

KDD y CRISP-DM: el mapa del proyecto

El algoritmo es solo una parte del proceso. Antes hay selección, limpieza y transformación; después, interpretación y despliegue.

3.1KDDCriterio 1.1.2

(Fayyad, Piatetsky-Shapiro y Smyth, 1996) recorre cinco etapas. Avanza por cada una siguiendo un caso real de una aseguradora.

KDD es iterativo: es común descubrir en la etapa 4 que faltan variables y volver a la etapa 1.
3.2CRISP-DMCriterio 1.1.2

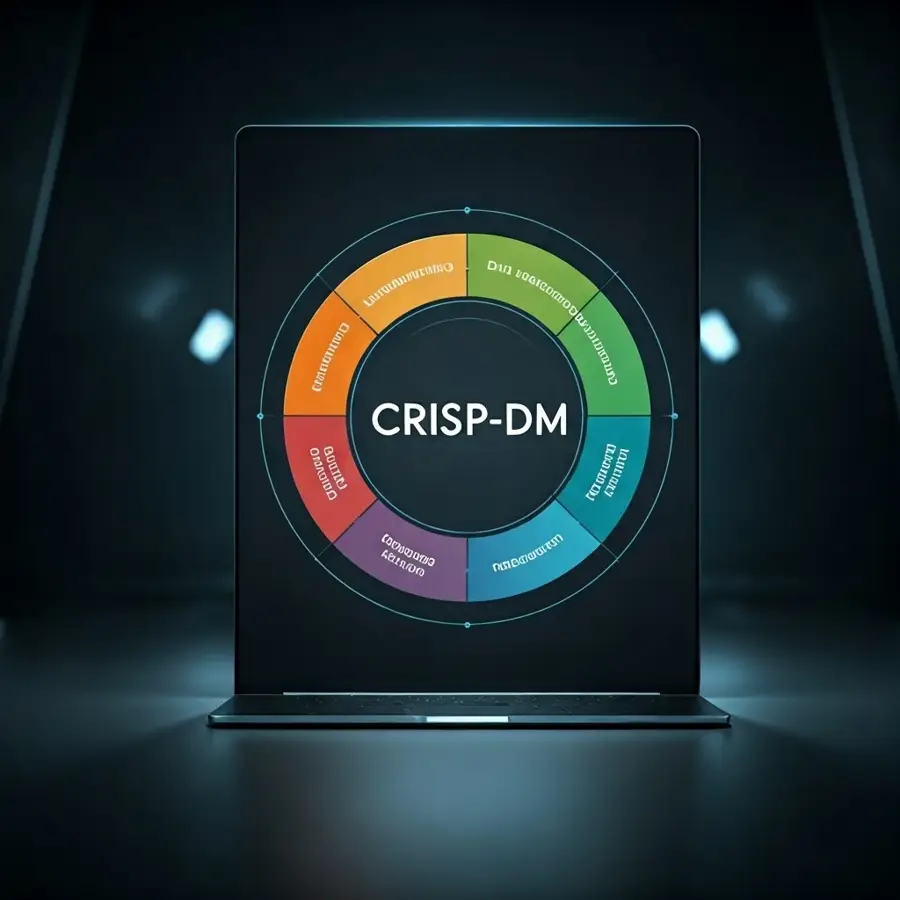
es la brújula para no perderse entre datos, algoritmos y objetivos.

Lo desarrolló a fines de los 90 un consorcio de empresas (Daimler-Benz, SPSS, NCR y OHRA según el material CRISP-DM; la lectura menciona DaimlerChrysler, SPSS y NCR en 1996). Seis fases cíclicas: se vuelve atrás cuando el análisis lo exige.

Rueda de las seis fases de CRISP-DM en la pantalla de un portátil
El ciclo CRISP-DM.

Recorre las fases · caso supermercado

Lectura, ejemplos aplicados
3.3Comparación

KDD y CRISP-DM organizan el trabajo con énfasis distintos.

KDDCRISP-DM
ÉnfasisProceso de descubrir conocimiento desde bases de datosGestión completa de un proyecto analítico
NegocioAsume que ya se sabe qué se buscaFase completa de comprensión del negocio
DespliegueTermina en la interpretaciónFase explícita de despliegue
OrigenAcadémico (papers)Industrial (empresas para empresas)
UsoInvestigaciónProblemas reales de organizaciones
CompartenSon iterativos, priorizan comprensión y preparación de datos y separan construcción del modelo de su evaluación.
3.4EDA dentro de CRISP-DMCriterio 1.1.2

¿Qué es el y es parte de CRISP-DM?

El Análisis Exploratorio de Datos (Exploratory Data Analysis) es un enfoque sistemático para analizar un conjunto de datos y resumir sus características principales con técnicas visuales y estadísticas. Lo popularizó el estadístico John Tukey en la década de 1970.

Sí, pero como componente, no como faseCRISP-DM tiene seis fases y ninguna se llama EDA. El material lo describe como un componente fundamental dentro de las fases de Comprensión de los datos y Preparación de los datos, que además informa a las demás fases: «El EDA no es un paso previo, es parte integral del ciclo de minería de datos».
Pantallas holográficas de datos sobre una mesa
El EDA se entrelaza con varias fases de CRISP-DM.

Para qué sirve

  • ·Detectar patrones ocultos en los datos
  • ·Identificar anomalías, valores atípicos y errores
  • ·Verificar supuestos estadísticos necesarios para el modelado
  • ·Descubrir relaciones entre variables
  • ·Seleccionar modelos y técnicas apropiadas

Sin un EDA riguroso…

  • ✗El modelado fracasa:
  • ✗La comunicación se debilita: no hay insights claros
  • ✗Se toman malas decisiones por suposiciones incorrectas
  • ✗Se desperdicia tiempo en retrabajos de fases avanzadas

Mapa navegable · 13 pasos del EDA × 6 fases de CRISP-DM

PDF «CRISP-DM y EDA», diapositivas del checklist y «Conexión final»
Toca una fase para ver qué pasos del EDA la sostienen, o toca un paso para ver qué significa, en qué fase vive y un ejemplo con la base IMC. Usa «Siguiente paso» para recorrerlos en orden.
Dos lecturas en el material del cursoEl PDF «CRISP-DM y EDA» incluye en su checklist pasos que corrigen datos (nulos, duplicados, balanceo, normalización), por eso esos pasos aparecen tanto en Comprensión como en Preparación. La primera clase separa más estrictamente: = diagnosticar (comprensión de datos) y = corregir (preparación). «Primero diagnostico; luego corrijo». La presentación de Software 2.0 agrupa limpieza, normalización, aumentado y visualización bajo «EDA» dentro de la Preparación de datos.
MÓDULO 04

Describir: valor típico y posición

La minería no parte modelando: primero entiende la muestra. Ruta: muestra → tendencia central → dispersión → distribución normal → distancias → entropía.

4.1Base IMCCriterio 2.1.3

Explora la base IMC del curso: elige una variable, filtra y observa cómo se reparte antes de resumirla en un número.

Preguntas de esta tarjeta

  1. Con «Edad» y «Todos»: ¿cuál es la edad media y la mediana de las 334 personas? ¿Están cerca o lejos? ¿Qué te dice eso sobre la forma de la distribución?
  2. Cambia a «Peso» y deja el percentil en P80: ¿qué peso deja por debajo al 80 % de las personas?
  3. Cambia a «Estatura» y compara «Femenino» con «Masculino»: ¿qué grupo tiene mayor estatura media y por cuántos centímetros?
  4. Vuelve a «Edad» y mueve las clases del histograma a 4 y luego a 25: ¿cambia la forma que percibes? ¿Por qué?
  5. ¿Cuál es la moda de la edad y cuántas veces se repite? ¿Por qué la moda dice poco en una variable numérica con muchos valores distintos?
Mueve las clases del histograma: la depende del tamaño de los intervalos y puede ocultar subgrupos.
Variable
Sexo
Institución
10
P80

Fuente: IMC.xlsx del proyecto · n filtrado mostrado en el gráfico. Percentiles con interpolación lineal (tipo 7, el predeterminado de R).

Respuestas esperadas 1 a 5 (base IMC completa)
  1. Media 44,42 años y mediana 43 años: están cerca. La media queda levemente sobre la mediana, lo que indica una asimetría positiva leve (0,27): algunas edades altas tiran el promedio hacia arriba.
  2. P80 del peso = 79,48 kg: el 80 % de las personas pesa 79,48 kg o menos.
  3. Masculino: 167,78 cm (n = 154). Femenino: 155,91 cm (n = 180). Diferencia: 11,87 cm a favor del grupo masculino.
  4. Sí. Con 4 clases se pierde el detalle; con 25 aparecen saltos y ruido. La frecuencia relativa depende del tamaño de los intervalos.
  5. Moda 59 años, 17 veces. En una variable numérica con muchos valores posibles, el valor más repetido puede depender del azar y no representar el centro.
Respuesta esperada: ¿por qué tres medidas de valor típico?

, y responden de forma distinta a «¿cuál es el valor típico?». La media se distorsiona con extremos; la mediana ignora magnitudes; la moda puede no existir o haber varias.

Con peras y manzanas

Si en una mesa hay seis personas con sueldos parecidos y llega alguien con un sueldo enorme, el «promedio» de la mesa sube mucho, pero la persona del medio sigue ganando lo mismo.

0.0Base IMCPresentación U1 · ejemplo

Cuartiles, quintiles, deciles y percentiles dividen los datos ordenados en 4, 5, 10 y 100 partes. Ejercicio de la presentación U1: calcula el primer cuartil, el segundo quintil, el tercer decil y el percentil 80 del peso.

Esquema de equivalencia

Todas son posiciones dentro del 0–100 %: Q1 = P25, segundo quintil = P40, tercer decil = P30, Q2 = quinto decil = P50 = mediana.

Cálculo paso a paso

posición = 1 + (n − 1) · p · si cae entre dos datos: valor = x₍ₖ₎ + fracción · (x₍ₖ₊₁₎ − x₍ₖ₎)

Es el método de interpolación lineal que usa R por defecto (quantile(x, type = 7)). Otros programas usan reglas levemente distintas y pueden dar decimales diferentes.


4.2Guía · Ejercicio 3

Ventas diarias de siete vendedores: 10, 11, 11, 12, 13, 14 y un séptimo valor. Arrastra el séptimo y mira qué medida resiste.

El 40 es un valor atípicoUn es una observación que se aleja mucho del resto de los datos. Aquí seis vendedores venden entre 10 y 14, y uno vende 40: ese dato «no se parece» a los demás. Los atípicos arrastran la media, pero casi no mueven la mediana.
40

Solucionario (con 40)

Media = 111/7 = 15,86 · Mediana = 12 · Moda = 11. La mediana representa mejor al vendedor típico porque el 40 es extremo y eleva la media.

MÓDULO 05

Dispersión y forma

Un promedio sin dispersión puede ser engañoso. Medimos cuánto se alejan los datos de su centro y qué forma tiene la distribución.

5.1Guía · Ejercicio 4

Dos sucursales venden en promedio 20 al día. ¿Se comportan igual? Aumenta la dispersión de la sucursal B.

1,0
Solucionario

A: (18+19+20+21+22)/5 = 20. B: (5+10+20+30+35)/5 = 20. Medias iguales, dispersión muy distinta: B es más dispersa; se cuantifica con o . A parece más estable.

5.2Guía · Ejercicio 5

Tiempos de atención de cinco solicitudes: 4, 6, 8, 10, 12 minutos. Calcula la varianza paso a paso; edita los valores para ver cómo cambia.

Poblacional divide por N; muestral por n−1. El material del curso usa la poblacional en este ejercicio.

Interpretación en lenguaje de negocio

Con 4, 6, 8, 10, 12: μ = 8, σ² = 40/5 = 8, σ = 2,83. Los tiempos se alejan típicamente alrededor de 2,83 minutos de la media de 8 minutos.

5.3Base IMC

Dispersión y forma en la base real: , , y , con su .

Entiende cada medida con un gráfico

Formas ilustrativas

Ahora con la base real y tus filtros

Usa los mismos filtros de la tarjeta (variable, sexo, institución): ambos laboratorios están conectados.

Cómo lee el boxplot los valores atípicos

La caja va del primer cuartil (Q1) al tercero (Q3); su ancho es el . Se considera atípico todo valor más allá de 1,5 × IQR desde los bordes de la caja: por debajo de Q1 − 1,5·IQR o por encima de Q3 + 1,5·IQR. Esos puntos se dibujan en rojo, fuera de los «bigotes».

Ejemplo real: en el IMC de la base los límites son 18,75 y 35,15; quedan fuera 4 personas (15,9 · 18,3 · 35,4 · 35,6). Selecciona «IMC» en el módulo 4 para verlas.

MÓDULO 06

Distribución normal y puntaje Z

La da sentido probabilístico a la media y la desviación; el permite comparar escalas distintas.

6.1Guía · Ejercicios 6 y 8Criterio 3.1.3

El tiempo de preparación de pedidos se comporta aproximadamente como una normal con μ = 40 y σ = 5 minutos. Un pedido demoró 50 minutos: ¿es habitual?

Casos
Banda sombreada

Solucionario ejercicio 6

68,3 %: 40 ± 5 → entre 35 y 45 min. 95,4 %: 40 ± 10 → entre 30 y 50. Z = (50−40)/5 = 2: el pedido está 2σ sobre la media, relativamente alejado; justo en el límite del intervalo que contiene ~95,4 %.

Solucionario ejercicio 8

= |85.000 − 70.000| / 10.000 = 1,5: el cliente está 1,5 desviaciones sobre la media. $10.000, 10 años o 10 puntos no significan lo mismo si sus dispersiones son distintas.

Con peras y manzanas

Medir «cuántas desviaciones» es como medir distancias en pasos de cada persona: 10 pasos de un niño no equivalen a 10 pasos de un adulto, pero «1,5 veces su paso típico» sí se puede comparar.

MÓDULO 07

Asociación entre variables

, y : ¿se mueven juntas dos variables? Base de la .

7.1Base IMCCriterio 2.1.3

La presentación «Estadística descriptiva» pide calcular las medidas de asociación entre el peso y el IMC. Compruébalo y luego prueba otros pares.

Eje X
Eje Y
Sexo
¿Qué no debo concluir?

Correlación no es causalidad. Además, si dos predictores están muy correlacionados entre sí aparece (VIF > 10), como habitaciones y tamaño de una vivienda.

7.2Base IMCRegresiónCriterio 2.1.4

El : ¿cuál es la «mejor» recta para predecir el peso a partir de la estatura?

La idea

Para cada persona, el residuo es la diferencia entre su peso real y el que predice la recta: eᵢ = yᵢ − ŷᵢ. Mínimos cuadrados elige la pendiente y el intercepto que hacen mínima la suma de los residuos al cuadrado.

SSE = Σ (yᵢ − ŷᵢ)² , con ŷ = a + b·x

Se elevan al cuadrado para que los errores positivos y negativos no se cancelen y para castigar más los errores grandes (la misma lógica de la varianza).

Fórmulas de la solución

b = Σ(xᵢ − x̄)(yᵢ − ȳ) / Σ(xᵢ − x̄)² = cov(x,y) / var(x)

a = ȳ − b · x̄

Se obtienen derivando SSE respecto de a y de b e igualando a cero. La recta óptima siempre pasa por el punto (x̄, ȳ).

Ajusta la recta a mano y compite con mínimos cuadrados

SSE según la pendiente (con la recta pasando por x̄, ȳ)

Métricas de error de una regresión

Lectura: MAE, MSE/RMSE y R²
MétricaFórmulaCómo se lee
· error cuadrático medio(1/n) Σ (yᵢ − ŷᵢ)²Promedio de los errores al cuadrado. Está en unidades al cuadrado (kg²). Es lo que minimiza mínimos cuadrados (SSE / n).
· raíz del ECM√MSEVuelve a las unidades de la variable (kg). Penaliza más los errores grandes que el MAE.
· error absoluto medio(1/n) Σ |yᵢ − ŷᵢ|Error promedio en las mismas unidades del objetivo; menos sensible a errores grandes.
· coeficiente de determinación1 − SSE / SST, SST = Σ (yᵢ − ȳ)²Proporción de la variabilidad que explica el modelo. 0 = no mejora a predecir siempre la media; 1 = ajuste perfecto.

Las fórmulas son las definiciones estándar; la lectura del curso describe estas métricas sin desarrollar su cálculo.

MÓDULO

R como herramienta

Ya calculaste a mano posición, dispersión, forma, normalidad y asociación. Ahora pídele esos mismos cálculos a R: todo lo de los módulos de estadística se reproduce con estos comandos sobre la base IMC.

0.0Por qué RCriterio 2.1.1

El descriptor exige un informe de la ejecución práctica del proceso de limpieza de datos y del método descriptivo y predictivo en R (Unidad 2, 35 %).

R
4.3.1
RStudio
2023.09.0
Peso UA2
35 %

Versiones del software estándar del descriptor TI3V61. R es el lenguaje; RStudio es el entorno donde se escribe y ejecuta el código.

Portátil con código en pantalla
Un script de R es una receta reproducible: cualquiera puede repetir tu análisis.
0.0Base IMCConsola

Elige un comando, lee qué hace y mira el resultado que produce con la base del curso. Avanza en orden: cargar, mirar, resumir, relacionar.

Los resultados se calculan en esta página con los mismos 334 registros de IMC.xlsx; el formato imita la salida de R pero puede diferir en espacios o decimales.

0.0dplyrBase IMC

Con dplyr se encadenan pasos con el operador |>: filtrar filas, agrupar y resumir. Arma tu propia consulta.

filter()
group_by()
summarise() de
0.0Script del informePropuesta

Un esqueleto de script para el informe de la Unidad 2: limpieza, método descriptivo y método predictivo, en el orden del checklist EDA.


Script propuesto por este laboratorio como guía; no forma parte del material entregado. Requiere los paquetes readxl, dplyr y class. Los nombres de columna con espacios o corchetes van entre comillas invertidas.

MÓDULO 08

Medir similitud: todas las distancias

Muchos algoritmos deben decidir qué objetos se parecen. Se elige la según el tipo de dato. Ruta: de la línea recta (euclidiana) a su familia, la escala, la correlación, los datos binarios, los conjuntos y textos, la dirección (coseno) y los datos mixtos.

8.1Guía · Ejercicio 7

Tres clientes en dos variables estandarizadas: A(1,1), B(5,4), C(2,2). Arrastra los puntos y mira cuál queda más parecido a A con la .

Solucionario

d(A,B) = √(16+9) = 5; d(A,C) = √2 ≈ 1,41. C es más parecido a A. Técnicas que usan cercanía: y .

8.2Familia MinkowskiComplemento

La euclidiana es un caso de una familia: la . Cambiando un parámetro p se obtienen Manhattan, Euclidiana y Chebyshev.

d_p(A,B) = ( Σ |aⱼ − bⱼ|^p )^(1/p)

p = 1 → · p = 2 → · p → ∞ → (la mayor diferencia).

Distancia

Puntos A(1,1) y B(5,4) de la Guía, ejercicio 7. La figura alrededor de A une todos los puntos que están a la misma distancia de A que B. Manhattan, Chebyshev y Minkowski no están en el material del proyecto: complemento.

8.3Base IMC

¿Por qué antes de medir distancias? Compara tres personas reales de la base usando edad (años) y estatura (cm).

8.4Base IMC

Estatura y peso se mueven juntos. Toca cualquier punto del gráfico: la distancia de considera esa correlación; la de no.

Las elipses unen puntos con la misma distancia de Mahalanobis (1, 2 y 3). Los círculos punteados equivalen a la distancia de Gauss estandarizada.

8.5Guía · Ejercicio 9

Dos clientes descritos con siete respuestas sí/no. Toca los bits y calcula la .

Cliente A
Cliente B
Solucionario

1011101 vs 1001001 difiere en las posiciones 3 y 5. Hamming = 2; normalizada 2/7 = 28,6 %. Una distancia baja indica perfiles parecidos. Euclidiana no expresa directamente la lógica de símbolos o códigos.

8.6Conjuntos y textos

No todo dato es un número. Para canastas de compra se usa ; para nombres o textos con errores de tipeo, .

Jaccard · ¿qué tan parecidas son dos canastas?

Complemento

J(A,B) = |A ∩ B| / |A ∪ B| · distancia de Jaccard = 1 − J

Cuenta solo lo que sí está en alguna canasta: no premia que ambas personas no hayan comprado lo mismo. Hamming, en cambio, cuenta también las ausencias compartidas.

Canasta cliente A
Canasta cliente B

Productos tomados de los ejemplos de canasta de la Lectura (pañales, cerveza, snacks) y de la sección inicial (café, galletas); las canastas son de ejemplo.

Levenshtein · ¿cuántas ediciones separan dos textos?

Lectura: duplicados aproximados

Número mínimo de operaciones de un carácter (insertar, borrar o sustituir) para convertir un texto en otro. La lectura la usa para detectar duplicados aproximados con nombres escritos distinto.

D[i][j] = min( D[i−1][j] + 1 , D[i][j−1] + 1 , D[i−1][j−1] + (aᵢ ≠ bⱼ) )

Texto 1
Texto 2

La matriz muestra el cálculo: cada celda es la distancia entre los prefijos. La esquina inferior derecha es el resultado. En amarillo, un camino de ediciones mínimo.

8.7Similitud cosenoComplemento

El une la distancia euclidiana con el ángulo entre dos vectores. De ahí nace la , muy usada en minería de textos.

Teorema del coseno

c² = a² + b² − 2ab·cos θ

En un triángulo con lados a y b que forman el ángulo θ, el tercer lado c se calcula así. Si θ = 90°, cos θ = 0 y queda Pitágoras.

Con vectores: ‖A − B‖² = ‖A‖² + ‖B‖² − 2‖A‖‖B‖·cos θ

El lado c es exactamente la distancia euclidiana entre los extremos de A y B.

Similitud coseno

cos θ = (A · B) / (‖A‖ · ‖B‖) = Σ aᵢbᵢ / (√Σaᵢ² · √Σbᵢ²)

Mide la dirección, no el tamaño: 1 = misma dirección, 0 = perpendiculares, −1 = opuestos. Distancia coseno = 1 − cos θ.

Útil cuando importa la proporción y no la magnitud: un comentario largo y uno corto que hablan de lo mismo.

Arrastra las puntas de los vectores

Ejes: frecuencia de las palabras «demora» y «precio» en un comentario (términos citados en la Guía, ejercicio 12; las frecuencias son de ejemplo). El teorema del coseno y la similitud coseno no están desarrollados en el material del proyecto: es contenido complementario.

8.8SíntesisCriterio 1.1.1

¿Qué distancia uso? Depende del tipo de dato (módulo ) y de lo que significa «parecerse» en el problema.

Datos mixtos: distancia de Gower con dos personas reales

Complemento

Cuando una fila mezcla números y categorías (como la base IMC), calcula una diferencia entre 0 y 1 por variable y las promedia:

numérica: |xᵢ − yᵢ| / rango · categórica nominal: 0 si son iguales, 1 si no · ordinal: |rango₁ − rango₂| / (niveles − 1)

Persona 1 (ID)
Persona 2 (ID)

Cuadro resumen de distancias

DistanciaFórmulaTipo de datoCuándo usarla · ejemploDónde
√Σ(aⱼ − bⱼ)²Numéricas en la misma escalaDistancia «en línea recta». KNN y k-means con variables estandarizadas: clientes A(1,1) y B(5,4) → 5. · material
Σ|aⱼ − bⱼ|NuméricasDesplazamiento por cuadras o en rejilla; menos sensible que la euclidiana a una sola diferencia grande; útil con muchas variables. A(1,1)–B(5,4) → 7. · complemento
máx |aⱼ − bⱼ|NuméricasCuando manda la peor diferencia: control de tolerancias en manufactura. A(1,1)–B(5,4) → 4. · complemento
(Σ|aⱼ − bⱼ|^p)^(1/p)NuméricasGeneraliza las tres anteriores; p se ajusta como hiperparámetro. · complemento
|x − μ| / σ · √Σzⱼ²Numéricas en escalas distintasComparar años, kg y pesos chilenos en unidades de desviación: gasto $85.000 con μ $70.000 y σ $10.000 → 1,5. y · material
√[(x−μ)ᵀS⁻¹(x−μ)]Numéricas correlacionadasDetectar atípicos considerando la correlación: persona alta y muy liviana en la base IMC. · material
nº de posiciones distintasBinarias o códigos de igual largoPerfiles sí/no de igual longitud: 1011101 vs 1001001 → 2. Cuenta también los «no» compartidos. · material
1 − |A∩B| / |A∪B|Conjuntos, binarias asimétricasCanastas de compra: importa lo comprado, no lo que ninguno compró. · complemento
mín. edicionesTexto cortoDuplicados aproximados: «Constructora ABC Ltda» vs «Constructora ABC LTDA». · material (Lectura)
1 − A·B / (‖A‖‖B‖)Vectores de frecuencias, textoComentarios largos y cortos sobre el mismo tema; importa la proporción, no el tamaño. · complemento
promedio de diferencias 0–1Mixtos (números + categorías)Comparar filas completas de la base IMC: sexo, institución, edad, estatura, peso. · complemento

Practica: elige la distancia

Aciertos
0 / 7
MÓDULO 09

Entropía, Gini y árboles de decisión

Después de medir diferencias, medimos incertidumbre de clases. La ganancia de información conecta la estadística con los modelos: elige variables que separan.

9.1Guía · Ejercicio 10

10 clientes: algunos compraron, otros no. Mueve la proporción y compara la con el : dos formas de medir qué tan mezcladas están las clases.

Entropía

H(S) = − Σ pᵢ · log₂(pᵢ)

Mide incertidumbre en bits. Con 2 clases va de 0 (puro) a 1 (50/50). Con c clases el máximo es log₂(c).

Índice de Gini

Gini(S) = 1 − Σ pᵢ²

Probabilidad de clasificar mal un caso al azar si se etiqueta al azar según las proporciones. Con 2 clases va de 0 (puro) a 0,5 (50/50). No usa logaritmos.

5

Entropía: Guía U1 y presentación «Estadística, distancias y entropía». El material menciona Gini como criterio alternativo en árboles; su fórmula es la definición estándar (CART) y no está desarrollada en el material.

9.2Base IMCGuía · Ejercicio 11Criterio 2.1.4

Objetivo: la clasificación de IMC (bajo peso, normal, sobrepeso, obesidad). ¿Qué variable reduce más la incertidumbre? Calcula la (o la reducción de Gini) con datos reales.

Ganancia = Impureza(S) − Σ (|Sᵥ| / |S|) · Impureza(Sᵥ)

Con entropía se llama ganancia de información: IG(S,A) = H(S) − Σ(|Sᵥ|/|S|)·H(Sᵥ). Con Gini se llama reducción de Gini. En ambos casos: impureza antes de dividir menos el promedio ponderado de la impureza de cada subconjunto.

Criterio
Dividir por

Cálculo paso a paso

Ojo: en esta base cada clase corresponde a un rango de IMC (verificado en los 334 registros: bajo peso hasta 18,3; normal 19,4–24,9; sobrepeso 25–29,9; obesidad desde 30) y el IMC coincide con peso / estatura². Por eso el peso separa mucho mejor que el sexo: la ganancia confirma lo que el dominio ya sabe.

Solucionario ejercicio 11

IG = 0,971 − 0,420 = 0,551 bits: la variable «número de reclamos» reduce la incertidumbre en 0,551 bits. Mayor ganancia = subconjuntos más puros, por eso sirve para elegir divisiones en árboles de decisión.

Limitación

La ganancia favorece atributos con muchos valores; por eso los árboles también usan gain ratio o Gini.

9.3Base IMCÁrbol de decisiónCriterio 2.1.4

Un árbol de decisión repite la idea anterior en cada nodo: prueba todas las divisiones posibles, elige la que más reduce la impureza y vuelve a dividir cada rama.

Cómo crece el árbol

  • 1Calcula la impureza del nodo (entropía o Gini).
  • 2Prueba cada variable y cada umbral posible («peso ≥ 75,3», «sexo = M»…).
  • 3Elige la división con mayor ganancia (o mayor reducción de Gini).
  • 4Repite en cada rama hasta llegar a la profundidad máxima o a un nodo puro.
  • ✓Cada hoja predice la clase mayoritaria de sus casos.

¿Entropía o Gini?

Ambos premian subconjuntos puros y suelen elegir divisiones parecidas. Gini no usa logaritmos y es más rápido de calcular. La ganancia de información tiende a favorecer atributos con muchos valores; por eso existen gain ratio o Gini (presentación «Estadística, distancias y entropía»).

Los árboles son fáciles de visualizar y explicar a no técnicos (Lectura).

Criterio
2
Variables disponibles

Árbol calculado en el navegador con los 334 registros reales; mínimo 5 casos por hoja. La exactitud se mide sobre los mismos datos de entrenamiento: no hay validación con datos no vistos.

MÓDULO 10

EDA: checklist de 13 pasos

Una guía estructurada para un análisis exploratorio profesional. Cada paso construye sobre el anterior y tiene una entrega mínima.

10.1ChecklistPDF CRISP-DM y EDACriterio 2.1.1

Abre cada paso, revisa la técnica y la entrega mínima, y márcalo cuando lo hayas practicado con la base IMC en R o Colab.

Pasos completados
0 / 13
Notebook con código en un portátil
El EDA no está completo hasta que es comunicable: notebook ordenado, dataset limpio y conclusiones.

Código Python: el que indica el material. Código R: equivalente propuesto para la base IMC (supone el archivo IMC.xlsx leído con readxl).

MÓDULO 11

Calidad y preparación de datos

«El modelo no arregla datos mal preparados; solo aprende sus problemas». La preparación es la fase que suele consumir más tiempo.

11.1CalidadCriterio 1.1.4

¿Cuánto tiempo se va en preparar datos? Las fuentes del curso no dan la misma cifra:

PDF EDA · ML2
80 %
Lectura
50–70 %

Ambas coinciden en que es la mayor parte del esfuerzo; la cifra exacta [REQUIERE VERIFICACIÓN] según la fuente que se cite.

Gráfico de líneas confuso en una tableta
Datos y gráficos descuidados llevan a decisiones erróneas.

Seis dimensiones de la · toca una

Wang & Strong (1996), citado en la Lectura
0.0Normas y marcosCriterio 3.1.2Fuentes externas

El criterio 3.1.2 pide aplicar técnicas de analítica «considerando la norma ISO 8000, 25012, TDQM y DMA-DMBOK». ¿Qué es cada una y cómo se conectan con las dimensiones de calidad que ya viste?

Origen del contenidoEl material del proyecto no desarrolla estas normas. Esta tarjeta resume fuentes públicas citadas al pie. El descriptor escribe «DMA-DMBOK»; se interpreta como DAMA-DMBOK, el marco de DAMA International [REQUIERE VERIFICACIÓN].

Puente con la Lectura

Dimensión (Lectura, Wang & Strong 1996)Característica cercana en ISO/IEC 25012Ejemplo en la base IMC
ExactitudExactitudUn IMC que no coincide con peso / estatura² sería inexacto: se verificó que coinciden en los 334 registros.
CompletitudCompletitudNo hay celdas vacías en las 8 columnas.
ConsistenciaConsistenciaLa clasificación coincide con los rangos de IMC en todos los registros.
ValidezConformidadSEXO solo toma «Femenino» o «Masculino».
ActualidadActualidadLa fecha de levantamiento de la base no está registrada [NO DEFINIDO].
Unicidad(no es una característica separada en 25012)No hay filas duplicadas sin contar el ID.

La correspondencia entre columnas es una interpretación de este laboratorio para relacionar ambas listas.

Fuentes: ISO 8000-1:2022 (iso.org) · datos.gob.es, «Normas técnicas para alcanzar la calidad del dato» (2022) · iso25000.com, ISO/IEC 25012 · MIT News (1993), programa TDQM · Wang, R. Y. (1998). A product perspective on total data quality management. Communications of the ACM, 41(2), 58–65 · Resumen de DAMA-DMBOK (Snowflake).

11.2DiagnósticoCriterio 2.1.2

Un registro sucio por fila, tomado de los ejemplos de la lectura. ¿Qué problema tiene y qué harías?

Aciertos
0 / 6
11.3Valores faltantes

Antes de tratar los , entiende por qué faltan: , o . Ajusta la situación y mira la estrategia que recomienda la lectura.

8 %
¿Hay patrón?
11.4Base IMCEDA · paso 4

Detecta en la base real con la regla o con Z-score, y prueba la .

¿Qué es un valor atípico?

Una observación que se desvía significativamente del patrón general de los datos. No todos son errores: algunos son datos reales extremos que contienen información valiosa.

  • ✗Error de medición o digitación: edad 150 años, precio −$5.000, estatura 300 cm. Se corrigen o eliminan.
  • ✓Evento real excepcional: un cliente que gasta $50.000 al mes y un mes gasta $5.000.000 porque compró un auto. Eliminarlo pierde información.

¿Cómo se detecta?

  • 1Regla IQR (boxplot): fuera de [Q1 − 1,5·IQR ; Q3 + 1,5·IQR].
  • 2Z-score: a más de 3 desviaciones estándar de la media (|z| > 3).
  • 3Investigación manual de los casos críticos: no automatizar ciegamente la eliminación.

Ejemplo real: con la regla IQR, en el peso de la base quedan fuera 2 personas (102,0 y 106,1 kg; límite superior 99,9 kg). Son pesos posibles en adultos: se investigan antes de tocarlos.

Preguntas de esta tarjeta

  1. Con «Peso» e «IQR» (k = 1,5): ¿cuántos atípicos hay y cuáles son los límites?
  2. Sube k a 3: ¿qué pasa con la cantidad de atípicos? ¿Por qué?
  3. Activa «Inyectar error de digitación»: ¿cuánto cambia la media y cuánto la mediana?
  4. Con el error activo, cambia a «Z-score»: ¿por qué los límites se ensanchan?
  5. ¿Eliminarías las personas de 102 y 106 kg? Justifica.
Variable
Método
Winsorizar
Respuestas esperadas
  1. 2 atípicos (102,0 y 106,1 kg); límites 40,7 y 99,9 kg.
  2. Con k = 3 los límites se abren y ya no queda ningún atípico: el criterio es más tolerante.
  3. La media sube notoriamente y la mediana casi no cambia: la mediana es robusta a extremos. Observa los valores exactos en los indicadores.
  4. El error infla la desviación estándar, y los límites del Z-score dependen de ella; la regla IQR, basada en cuartiles, casi no se mueve.
  5. No sin investigar: son pesos posibles en adultos y no hay evidencia de error. La lectura recomienda no automatizar la eliminación y validar con el dominio.
11.5Base IMCEDA · paso 10

Escala una variable con , o . Agrega un valor extremo y compara qué método se deforma.

Variable
Método
11.6Base IMCEDA · paso 9

En la base, «Obesidad» es la clase minoritaria frente al resto. Prueba técnicas de balanceo, y mira cómo crea puntos sintéticos entre vecinos.

Técnica
5

Puntos reales: estatura y peso estandarizados. Los puntos sintéticos son generados por este laboratorio y no forman parte de la base.

11.7Errores comunes

Seis errores típicos del análisis exploratorio y cómo evitarlos.

Gráfico sin etiquetas y con colores confusos
Mal diseñado: sin etiquetas, colores confusos.
Gráfico financiero claro y ordenado
Bien diseñado: claro, etiquetado, profesional.
MÓDULO 12

Describir o predecir: los modelos

Elegir el tipo de modelo equivocado es uno de los errores más costosos. La diferencia depende de la pregunta: «¿qué pasó?» o «¿qué pasará?».

12.1Mapa de modelosCriterio 1.1.3

Descriptivos ·

  • ·: farmacias que descubren 5 segmentos en 500.000 clientes.
  • ·: pañales + cerveza → snacks.
  • ·: 150 exámenes en 5 componentes.
  • ·: compra inusual a las 3 AM.

Su éxito se mide por interpretabilidad y utilidad práctica.

Predictivos ·

  • ·: banco con 50.000 créditos «pagado / impago».
  • ·: tasación de departamentos en Santiago.

Su éxito se mide por precisión en datos no vistos (generalización).

Netflix usa ambosDescriptivo: clustering de usuarios según lo que ven. Predictivo: probabilidad de cancelación para ofrecer un descuento. El cluster inicial incluso puede volverse variable objetivo de un modelo predictivo.
12.2Base IMCSupervisadoCriterio 2.1.4

: toca el gráfico para ubicar a una persona nueva por estatura y peso. Sus k vecinos etiquetados votan su clase.

Desactiva la estandarización: el peso y la estatura tienen escalas distintas y los vecinos cambian.
5
12.3Base IMCNo supervisado

sobre edad e IMC, sin entregarle ninguna etiqueta. Avanza paso a paso: asignar puntos, mover centroides, repetir.

3

· base IMC

¿Cómo se calcula el codo? →
Qué no prometer con clusteringNo crea etiquetas semánticas: el nombre del grupo lo interpreta una persona. Depende de la escala, de K y de la distancia.
K en K-means versus K en KNN

K-means: K = número de grupos que quiero formar; no requiere etiquetas (no supervisado). KNN: K = número de vecinos que consulto; requiere etiquetas (supervisado).

Demo en R de la primera clase (iris sin Species)
datos <- iris[, 1:4]
datos_scaled <- scale(datos)
set.seed(123)
km <- kmeans(datos_scaled, centers = 3, nstart = 25)
iris$cluster <- factor(km$cluster)
# ¿Qué columna NO usamos para entrenar k-means?
# Respuesta: iris$Species, porque sería una etiqueta.
Jerárquico versus no jerárquico

: construye un árbol (dendrograma); K se elige al cortarlo. No jerárquico o particional (k-means): busca una partición directa; K se define antes. Ambos son no supervisados.

12.4Método del codoPaso a paso

¿Cómo se calcula el y por qué se busca un «codo»?

La idea del material«Probamos varios K y buscamos dónde la mejora deja de ser grande». No existe un K perfecto automático: se combinan métricas e interpretación, y el resultado debe tener sentido para el problema (Primera clase).

Paso 1 · Para cada K, medir qué tan compactos quedan los grupos

9 puntos de ejemplo

WCSS(K) = Σgrupos Σpuntos del grupo distancia(punto, centroide de su grupo)²

WCSS (suma de cuadrados dentro de los grupos, también llamada inercia) suma la al cuadrado de cada punto a su propio centroide. Es lo que k-means minimiza; en el laboratorio aparece como «Suma intra-grupo». Esta fórmula es la definición estándar de k-means: el material del curso nombra el método pero no detalla el cálculo.

1

Paso 2 · Graficar WCSS contra K y mirar cuánto mejora cada K adicional

Paso 3 · ¿Por qué esa regla?

  • 1WCSS siempre baja al aumentar K. Más centroides significa que cada punto queda más cerca de alguno. Con K = n (un grupo por punto), WCSS = 0.
  • 2Por eso no sirve elegir el K con menor WCSS: siempre ganaría K = n, que no agrupa nada.
  • 3Se mira la mejora de cada K adicional, medida como la caída de WCSS respecto de la WCSS con K = 1 (la tabla del paso 2). Mientras el nuevo grupo separa grupos que realmente existen, WCSS cae mucho. Cuando ya solo parte en pedazos un grupo real, la caída es pequeña.
  • 4El «codo» es ese quiebre: el último K que todavía trae una mejora grande. Agregar más grupos complica la interpretación sin ganar mucha compacidad.
  • !Límite: a veces la curva baja suave y no hay codo claro, como en la base IMC del laboratorio . Ahí se decide con interpretación: ¿los grupos tienen sentido para el problema?
Con peras y manzanas

Ordenas ropa en cajones. Pasar de 1 cajón a 3 (poleras, pantalones, calcetines) ordena muchísimo. Pasar de 3 a 4 separando calcetines blancos de negros ayuda un poco. Pasar a 9 cajones casi no ordena más y cuesta encontrar las cosas. El codo está donde dejar de agregar cajones ya no vale la pena.

0.0Base IMCNo supervisado

El no pide K al inicio: une paso a paso los grupos más cercanos y dibuja un . Después se «corta» el árbol para decidir cuántos grupos usar.

Aglomerativo (el de este laboratorio)

  1. Cada persona empieza como su propio grupo.
  2. Se unen los dos grupos más cercanos.
  3. Se repite hasta que queda un solo grupo.
  4. La altura de cada unión en el dendrograma es la distancia a la que se unieron.

Divisivo

Parte de un gran grupo con todos y lo va separando. Ambos son no supervisados (primera clase).

¿Cómo se mide la distancia entre grupos?

Enlace simple (los dos puntos más cercanos), completo (los más lejanos), promedio (todas las parejas) o Ward (lo que más aumenta la suma intra-grupo). Estos criterios son complemento: el material no los detalla.

Enlace

Dendrograma

Grupos en edad e IMC (estandarizados)

12.5Asociación

Un supermercado chileno analiza 10 millones de transacciones: «pañales + cerveza → snacks salados», soporte 12 %, confianza 68 %. ¿Es una asociación fuerte? Depende del .

La lectura informa soporte y confianza, pero no P(snacks): ese valor queda [NO DEFINIDO] y aquí lo mueves para ver su efecto.

MÓDULO 13

Evaluar: ¿el modelo sirve?

Un modelo útil no es solo el que tiene buena métrica: es el que ayuda a decidir mejor.

13.1FraudeSimulación didáctica

Un detector de fraude no solo debe acertar: debe encontrar suficientes fraudes sin bloquear demasiados clientes legítimos. Mueve el umbral de alerta.

Todas las métricas de la matriz de confusión, con los números del umbral actual

· todos los umbrales

Cómo se lee la ROC

Cada punto es un umbral: en el eje X la tasa de falsos positivos (FPR) y en el eje Y la tasa de verdaderos positivos (recall). Bajar el umbral mueve el punto hacia arriba y a la derecha.

El AUC es el área bajo la curva: 0,5 equivale a adivinar al azar (diagonal) y 1 a separar perfecto. Mide la capacidad de distinguir clases sin fijar un umbral (Lectura).

1.000 transacciones simuladas con puntajes de riesgo generados por el laboratorio. No son datos reales. Las métricas de la lectura son exactitud, precisión, recall, F1 y AUC-ROC; especificidad, FPR, FNR, VPN y exactitud balanceada se agregan con su definición estándar.

Las métricas

· · · · . En regresión: y .

13.2Casos de la lectura

Evaluar es contrastar con el negocio, no solo con la métrica.

Aseguradora · KDD

Árbol de decisión82 %
Red neuronal85 %

La red alcanza más precisión, pero es mucho más difícil de interpretar para el equipo de negocios.

Supermercado · CRISP-DM

Retención sin modelo20 %
Piloto con cupones35 %

Piloto con 1.000 clientes en riesgo. El modelo falló en clientes de menos de 6 meses: se decidió un modelo separado para ellos antes del despliegue masivo.

Evaluar también es preguntar: ¿es verdadero?, ¿es útil?, ¿es entendible?, ¿es responsable?
13.3Base IMCMatriz multiclase

Con más de dos clases la matriz de confusión crece: filas = clase real, columnas = clase predicha. Evalúa el KNN del módulo sobre las 4 clases de IMC.

Se usa validación leave-one-out: cada persona se predice con sus vecinos sin incluirse a sí misma, así ningún caso se evalúa con datos que el modelo «ya vio».
5

Métricas por clase

Macro = promedio simple de las clases (todas pesan igual). Ponderado = promedio según la cantidad de casos de cada clase. Con clases desbalanceadas, como «Bajo peso» con 2 casos, ambos pueden diferir mucho.

MÓDULO 16

Redes neuronales: cómo se construyen y aprenden

De una neurona a una red que aprende con la base IMC. Cada pieza es un algoritmo: propagación hacia adelante, función de pérdida, retropropagación y descenso de gradiente.

Contenido complementarioEl material del proyecto menciona las redes neuronales (Lectura; presentación de Software 2.0: arquitectura, validación, hiperparámetros, sobreajuste, poda y cuantización) pero no desarrolla su funcionamiento interno. Las fórmulas de este módulo son las definiciones estándar y se indican como complemento.
16.1La neurona

Una multiplica cada entrada por un peso, suma un sesgo y pasa el resultado por una función de activación.

z = w₁·x₁ + w₂·x₂ + b → ŷ = f(z)

x = entradas (por ejemplo, estatura y peso estandarizados) · w = (cuánto importa cada entrada) · b = sesgo · f = .

Activación
16.2Funciones de activación

La introduce no linealidad: sin ella, muchas capas equivalen a una sola recta. Su derivada es la que usa la retropropagación.

FunciónFórmulaRangoDerivadaUso típico
Escalón1 si z ≥ 0, si no 0{0, 1}0 (no se puede entrenar por gradiente)Perceptrón histórico
Sigmoideσ(z) = 1 / (1 + e^−z)(0, 1)σ(z)·(1 − σ(z))Salida de clasificación binaria (probabilidad)
Tanh(e^z − e^−z) / (e^z + e^−z)(−1, 1)1 − tanh²(z)Capas ocultas, centrada en 0
ReLUmax(0, z)[0, ∞)1 si z > 0, si no 0Capas ocultas de redes profundas
Leaky ReLUz si z > 0, si no 0,01·z(−∞, ∞)1 o 0,01Evita neuronas «muertas» de ReLU
Linealz(−∞, ∞)1Salida de regresión
Softmaxe^zₖ / Σⱼ e^zⱼ(0, 1), suman 1pₖ(δₖⱼ − pⱼ)Salida multiclase
16.3Descenso de gradiente

Entrenar es bajar por la : en cada paso, los pesos se mueven en contra de la pendiente.

w ← w − η · ∂Pérdida/∂w

η es la : muy pequeña avanza lento; muy grande rebota o diverge. Es el mismo principio que usa el botón «Bajar por descenso de gradiente» de mínimos cuadrados ().

Pérdida de ejemplo L(w) = (w − 1)² + 0,5, mínimo en w = 1.

16.4Retropropagación

La calcula cuánto contribuye cada peso al error usando la regla de la cadena, de la salida hacia la entrada. Sigue una iteración completa con números.

Persona de entrenamiento

Una neurona sigmoide con entradas z-estatura y z-peso de una persona real de la base y objetivo y = 1 si su clasificación es «Obesidad». Pérdida: entropía cruzada binaria.

16.5Base IMCRed entrenándose

Una red con una capa oculta aprende a reconocer «Obesidad» a partir de la estatura y el peso. Elige la arquitectura y los hiperparámetros, y mírala aprender.

4
Activación oculta

Frontera de decisión

Arquitectura y pesos

Pérdida por época · entrenamiento y validación

Datos reales: 334 personas; 70 % entrenamiento y 30 % validación con semilla fija. Entradas estandarizadas. Salida sigmoide, pérdida entropía cruzada, descenso de gradiente por lotes completos.

16.6Mapa de algoritmos

Todos los algoritmos que intervienen al construir una red neuronal, en orden. Toca cada uno.

MÓDULO 14

A producción: Software 2.0 y MLOps

Desplegar no significa terminar: se monitorea, se mide y se mejora. ¿Por qué cuesta tanto pasar del paper a la realidad?

14.1Software 2.0

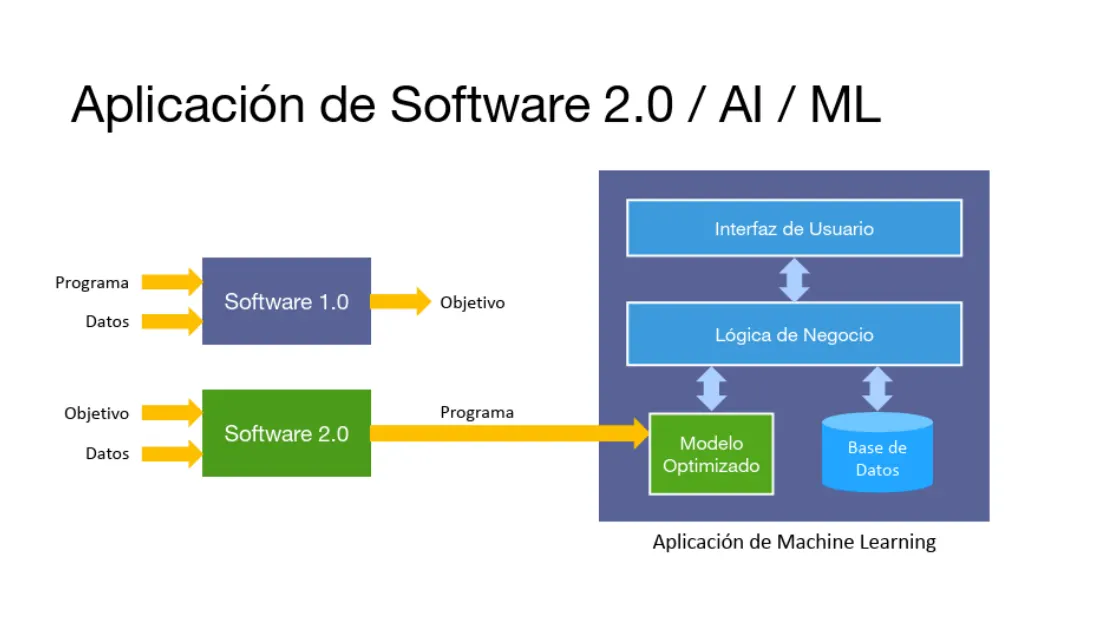
En no se escribe el programa: se entregan objetivo y datos, y el proceso produce un modelo optimizado.

Gartner 2018
85 %
Gartner 2022
54 %

Según Gartner, citado en la presentación: en 2018 se proyectaba que el 85 % de los proyectos de IA fracasaría en 2022; en 2022, el 54 % de los pilotos pasaba a producción. Razones: falsas expectativas, planificación como software 1.0, sin criterio de éxito, inversión difícil de justificar y falta de experiencia en despliegue.

Diagrama: Software 1.0 recibe programa y datos; Software 2.0 recibe objetivo y datos y produce un modelo
Software 1.0 vs 2.0 y la aplicación de ML.
0.0Mejores prácticasML2

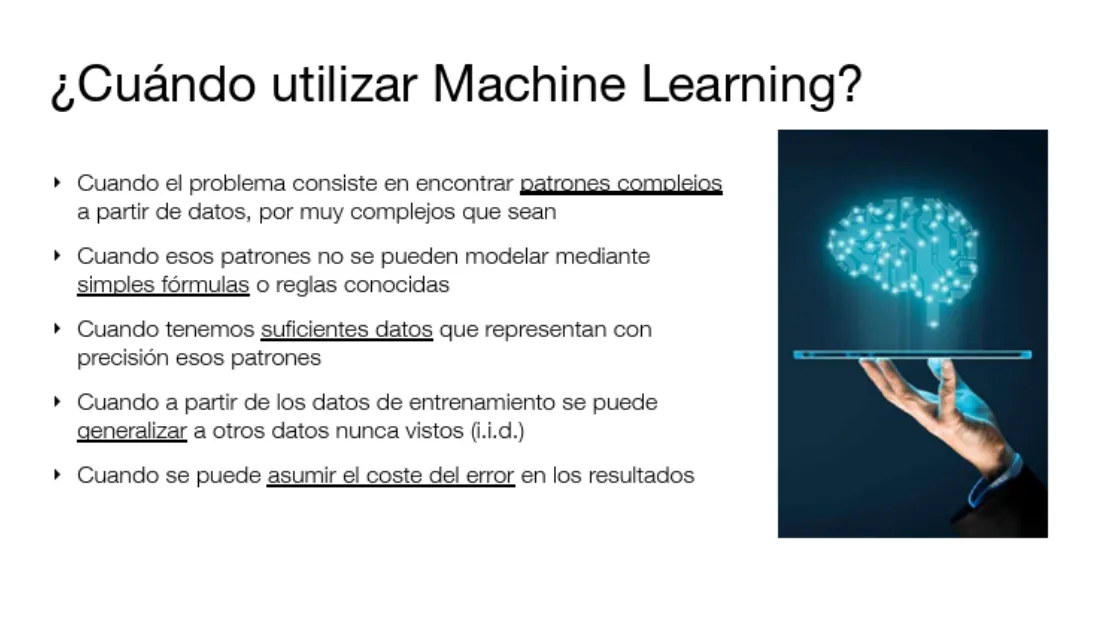
¿Cuándo conviene usar Machine Learning? La presentación da cinco condiciones. Revisa un caso y decide.

Diapositiva: cuándo utilizar Machine Learning
Diapositiva «¿Cuándo utilizar Machine Learning?».

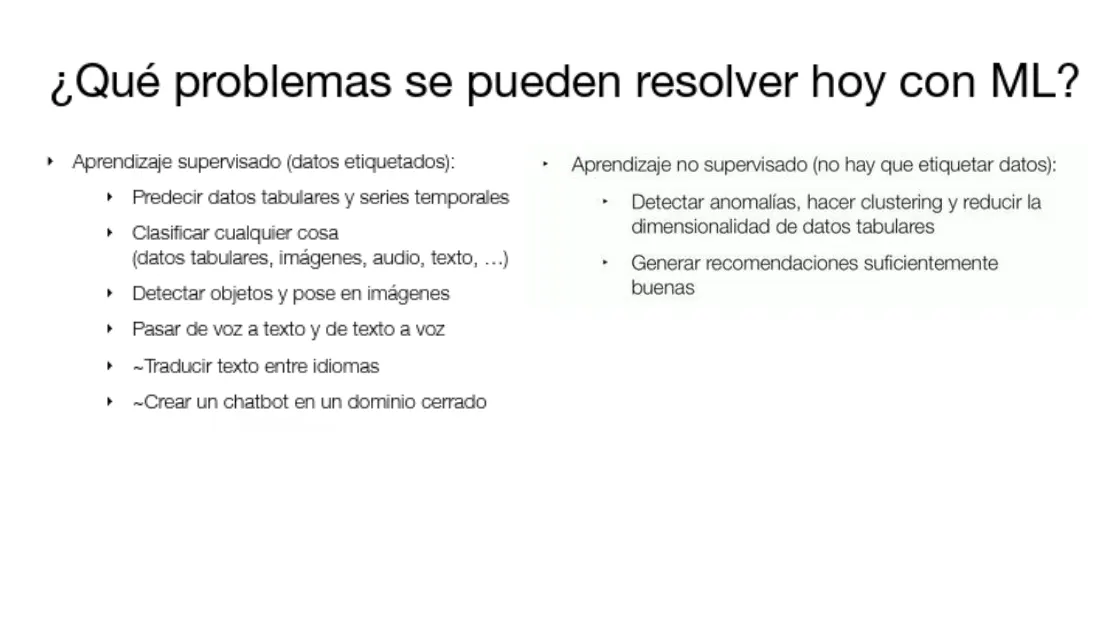
¿Qué problemas se pueden resolver hoy con ML?

ML2

Supervisado (datos etiquetados)

  • ·Predecir datos tabulares y series temporales
  • ·Clasificar datos tabulares, imágenes, audio, texto
  • ·Detectar objetos y pose en imágenes
  • ·Voz a texto y texto a voz
  • ~Traducir texto entre idiomas
  • ~Chatbot en un dominio cerrado

No supervisado (sin etiquetas)

  • ·Detectar anomalías, clustering y reducir la dimensionalidad de datos tabulares
  • ·Generar recomendaciones suficientemente buenas

«~» indica que la diapositiva los marca con una tilde, como resueltos solo en parte.

Diapositiva: problemas que se pueden resolver hoy con ML
14.2Ciclo de vida
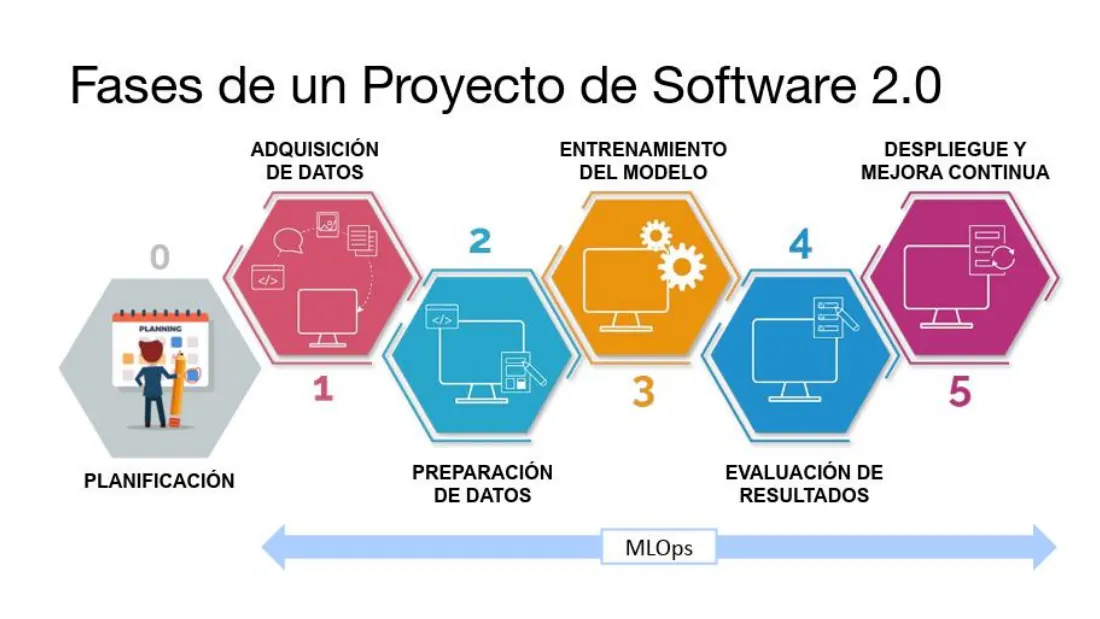
Seis hexágonos: planificación, adquisición, preparación, entrenamiento, evaluación y despliegue, unidos por MLOps
Fases de un proyecto de Software 2.0. Toca cada fase abajo para ver sus tareas y cuándo se retrocede.
14.3Planificación

Prioridad: alta viabilidad técnica + alta viabilidad de negocio. Ubica un proyecto en la matriz.

Técnica: limitaciones de la IA, datos y costo, métricas y , recursos y cronograma. Negocio: beneficios directos e indirectos, , riesgos de seguridad, legales y éticos.

14.4Métricas

100 % es imposible. Mejorar una métrica en el rango alto aumenta exponencialmente el costo del proyecto.

Curva ilustrativa con la forma de la diapositiva «Métricas» (eje 50 %, 90 %, 99 %, 99,9 %); el costo no tiene unidades.

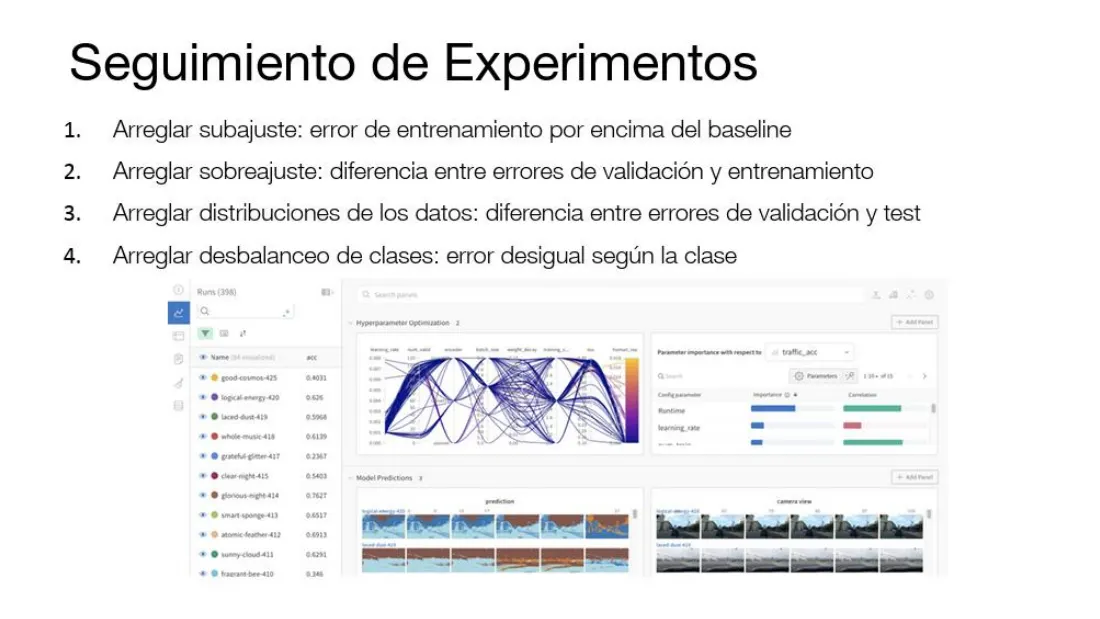
0.0Seguimiento de experimentosML2

Al entrenar se comparan errores en orden: baseline, entrenamiento, validación y prueba. La brecha entre cada par dice qué arreglar primero.

    Diapositiva: seguimiento de experimentos con un panel de herramientas
    Diapositiva «Seguimiento de experimentos». Errores del laboratorio: valores de ejemplo para practicar el diagnóstico.
    14.5Expectativa vs realidad

    Esperado: adquirir datos, entrenar, desplegar. Realidad: avanza el ciclo y mira cuántas vueltas da.

      Fuente citada en la presentación: cs329s.stanford.edu · Chip Huyen.

      AcademiaEmpresa
      ObjetivoMétricas de evaluaciónMétricas de negocio
      DatosFijos, públicosCambiantes, privados
      PrioridadEntrenamientoInferencia
      SesgosOpcionalCrítico
      InterpretabilidadOpcionalImportante
      MLOpsAccesorioFundamental
      14.6Monitorización

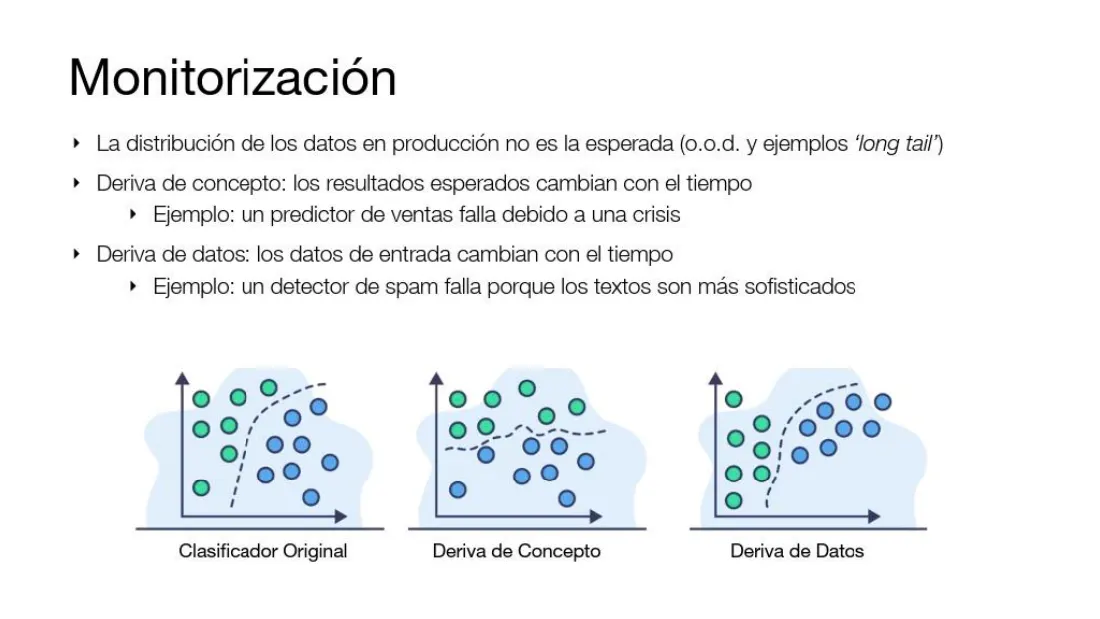
      Los modelos se degradan. ¿Qué cambió: los datos de entrada o la relación con el resultado?

      Tres gráficos: clasificador original, deriva de concepto y deriva de datos
      Diapositiva «Monitorización» del material.
      14.7Despliegue

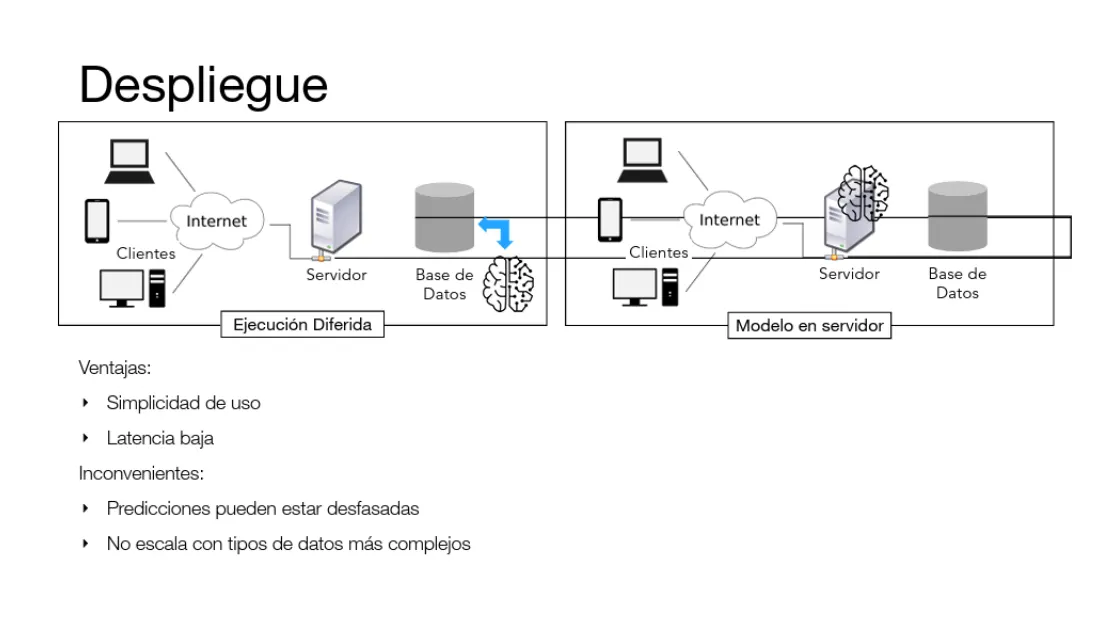
      ¿Dónde vive el modelo? Compara las cuatro formas de despliegue.

      Diagrama de despliegue
      14.8Equipo y deuda
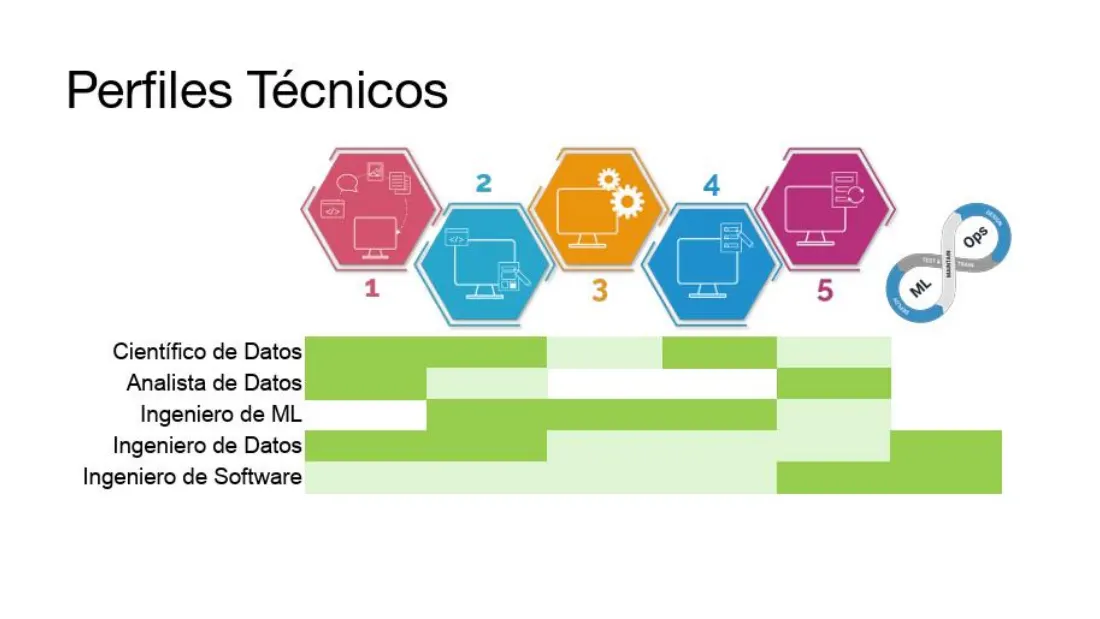
      Matriz de perfiles técnicos por fase
      Perfiles técnicos: científico, analista, ingeniero de ML, de datos y de software.
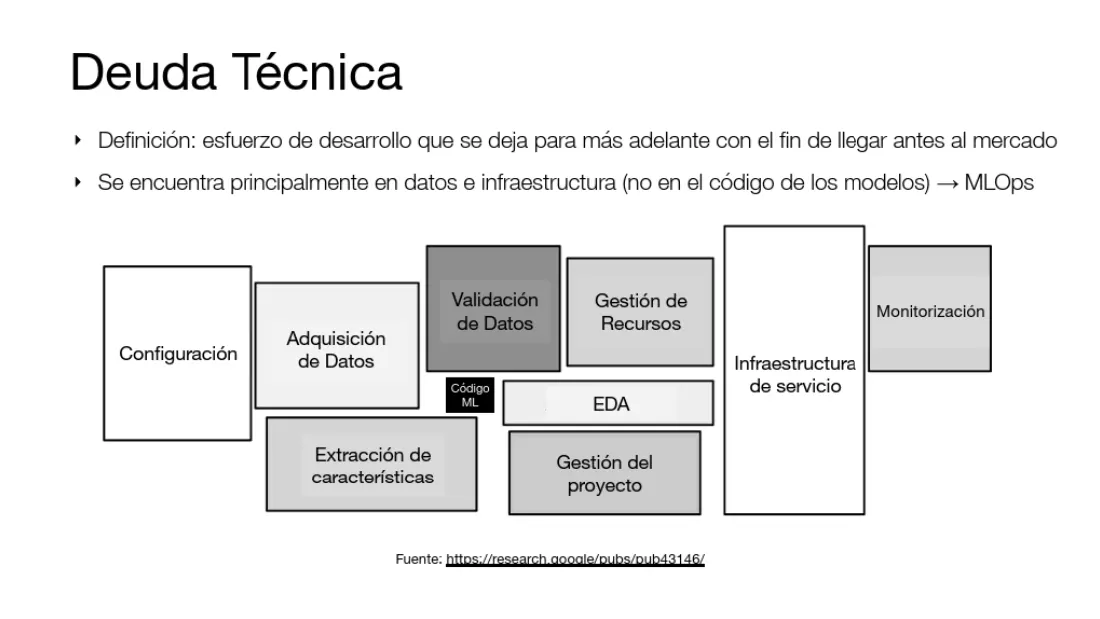
      El código ML es un bloque pequeño rodeado de bloques de infraestructura
      : el código ML es una pieza pequeña. Fuente citada: research.google/pubs/pub43146.

      Gestión de los datos

      • 1Adquirir más datos siempre ayuda; aumentar datos es la segunda opción; generar sintéticos, la tercera.
      • 2 es tan importante como versionar código.
      • 3Pocas etiquetas → aprendizaje semi-supervisado. Problemas de privacidad → aprendizaje federado.

      Bajo desempeño de un modelo

      • !Errores de programación: librerías probadas, vigilar inestabilidad numérica.
      • !Modelo no adecuado: empezar con el más simple posible.
      • !: valores por defecto, comparar con artículos.
      • !Conjunto de datos: subconjunto pequeño, medir convergencia, EDA riguroso.
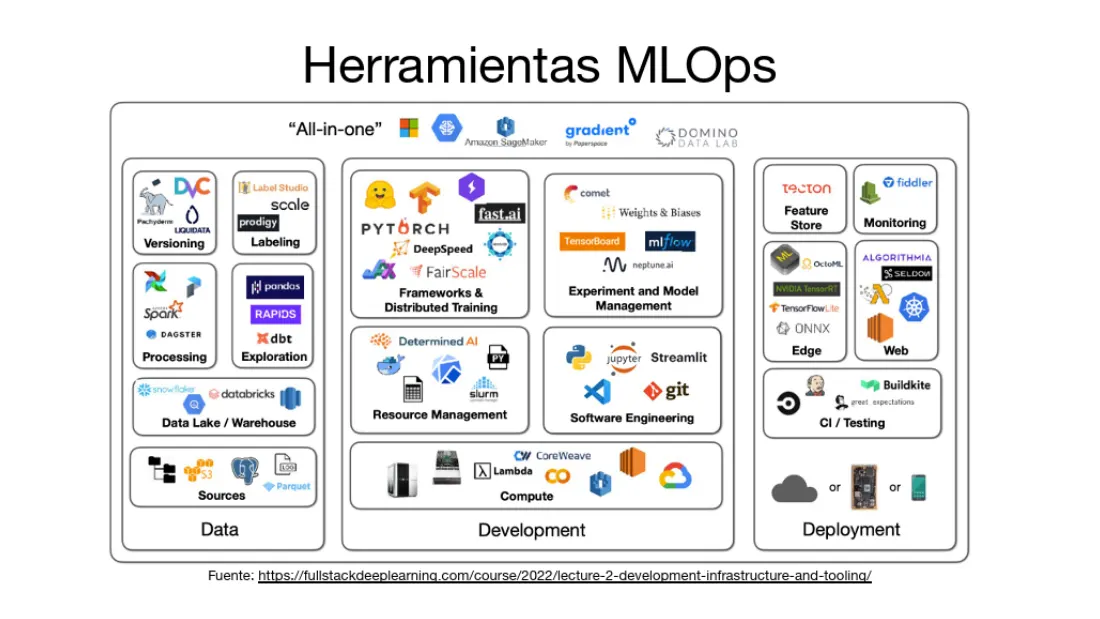
      Mapa de herramientas MLOps por datos, desarrollo y despliegue
      Herramientas MLOps. Fuente citada: fullstackdeeplearning.com (2022). Antes de usar un modelo pre-entrenado, revisa su licencia y su .
      0.0InfraestructuraML2

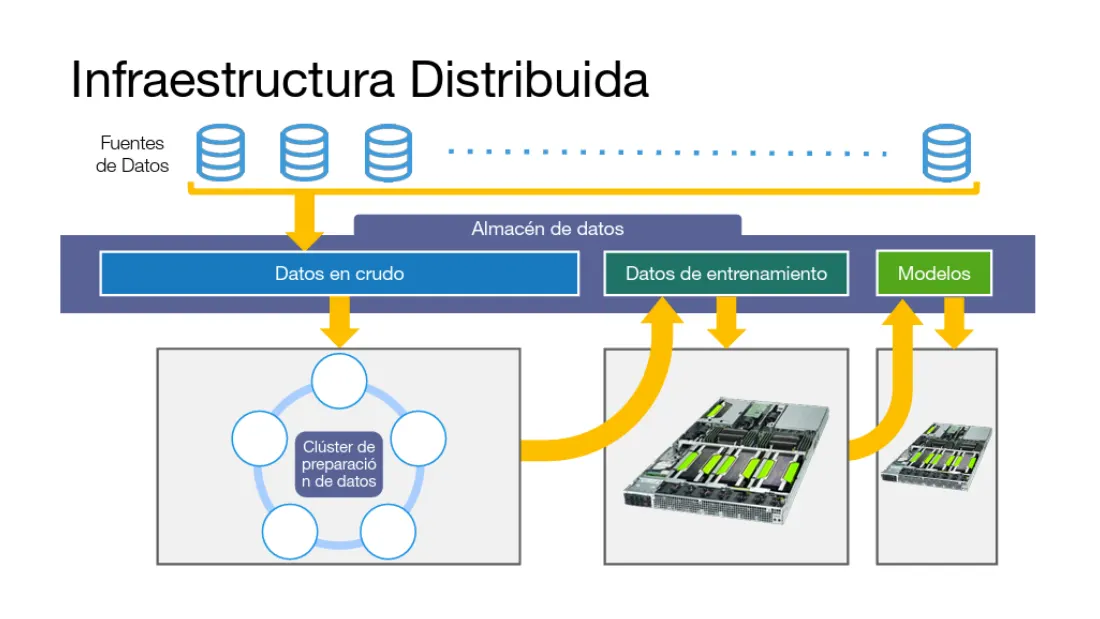
      ¿Dónde se preparan los datos, se entrena y se guardan los modelos? Compara la infraestructura distribuida con la local.

      Infraestructura distribuida
      MÓDULO

      Ética y ciudadanía en la minería de datos

      El descriptor pide generar conocimiento «considerando la ética y la ciudadanía». El material del curso entrega las pistas: sesgos, explicabilidad, privacidad, errores con costo para personas y criterio humano.

      0.0Principios

      «A mayor impacto en personas, mayor responsabilidad en calidad, explicabilidad y ética» (Clase 1). Toca cada principio para ver de dónde sale y un ejemplo.

      0.0Base IMCSesgos

      Un modelo puede funcionar bien «en promedio» y mal para un grupo. Evalúa el KNN de la base IMC separando los resultados por grupo.

      Comparar por
      5

      KNN con estatura y peso estandarizados, validación leave-one-out, sobre las 4 clases de IMC. Grupos con pocos casos (CAPREDENA 11, DIPRECA 7) dan porcentajes poco estables.

      0.0Revisión de un proyecto

      Antes de desplegar, cada proyecto responde cuatro preguntas: ¿es verdadero?, ¿es útil?, ¿es entendible?, ¿es responsable? (Clase 1). Elige un caso del curso y revísalo.

      NormativaLa normativa de protección de datos personales aplicable a un proyecto no está incluida en el material del curso [PENDIENTE]. La base IMC del curso no contiene nombres: las personas se identifican solo por un ID.
      MÓDULO 15

      Práctica: guía de ejercicios Unidad 1

      Doce ejercicios de la guía de la Unidad 1. Sin R ni programación: cálculo básico, interpretación y razonamiento.

      Códigos de criterio de la guíaLos códigos 1.1.1 a 1.1.5 que cita la guía no coinciden con los criterios de la Unidad 1 del descriptor TI3V61 (1.1.1 a 1.1.4, con otra redacción). Se muestran tal como aparecen en la guía [REQUIERE VERIFICACIÓN].
      Ejercicios 1 a 6 como práctica guiada; 7 a 12 como preparación de evaluación. Siempre justifica: identificación del problema, cálculo, interpretación y justificación.